

网站时光机保存的是页面过去长什么样,不是这个域名过去干不干净。有人拿它当老域名的体检报告,翻完一圈快照,看历史挺正常,就放心买了。真正该看的两样东西,它一样都不在里面。
网站时光机就是 Internet Archive 名下的 Wayback Machine,入口是 web.archive.org。首页一个搜索框,填入域名回车,就能看到这个站在时间轴上留下的历史快照,哪一年哪一月长什么样,点进去就能看。
对做独立站的人,这件事的用处不在怀旧。拿一个域名之前,它历史上被谁用过、放过什么内容、后来改成了什么样,都在这条时间轴上;盯一个竞品,它哪一年换的品类、动过哪几处导航,也在上面。接手域名只是开头,后面还有运营的一整套动作,独立站运营那篇铺得更全。
- 它是什么:Internet Archive 的 Wayback Machine,「网站时光机」和「网页时光机」都是它的中文叫法。
- 入口在哪:web.archive.org,首页搜索框里填域名。
- 能查什么:某个时间点这个站的标题、导航、品类和正文;用 API 还能批量判断某个 URL 有没有存档。
- 本文讲什么:查老域名历史、盯竞品改版,两个动作拆成 5 个能照着做的步骤。
查老域名历史和盯竞品改版,拆成 5 个步骤,数字和限制写在它们该出现的地方。
本文目录
网站时光机是什么,和「网页时光机」是同一个东西吗
是同一个东西。两个中文叫法,对应的都是 Internet Archive 做的 Wayback Machine,打开的都是 web.archive.org。没有两个产品。
Internet Archive 在自己的博客里给过一套定义。存档下来的带时间戳的网络对象叫 web capture,累计已经超过 5100 亿个。
「网页」这个口径比 web capture 窄。官方博客写的定义是:网页是一种有效的 web capture,且必须是 HTML 文档、纯文本文档或 PDF。图片、视频不在这个口径里。
「网站」的口径又不一样。官方定义是一个提供过网页、并且至少有一条来自其他域名网页的入链的 host。
domain 和 host 是两个层级。domain 是互联网命名空间里被拥有的一片,比如 google.com、archive.org、bbc.co.uk。host 由 FQDN 标识,FQDN 由 hostname 和 domain name 两部分组成。blog.archive.org 这个 host,hostname 是 blog,落在 archive.org 这个域里。
这组定义对查老域名有实际影响。你在搜索框里填的是域名,看到的是这个域名下各 host 留下过的快照。填 blog.example.com 和填 example.com,出来的时间轴不是一回事。
官方博客那篇定义文章里写过一个当时的数字:持有的网页来自 3.61 亿多个网站,共 2730 亿个网页,占 15 petabytes 存储。这几个数是那篇文章发布时的量级,不用当今天的精确值,但能说明覆盖面到了什么程度。
快照能看什么,不能看什么,要分开。能看的是那个时间点页面上写过的字、排过的导航、上过的品类。看不到的是页面背后的流量、收入和处罚记录。查历史快照,查的是前者。
把快照里的内容和自己的站对上,还差一层:怎么让页面从被收录走到有点击,收录到点击那篇写的就是这一段。
为什么查历史快照对独立站运营有用:两个具体动作
用处落在两个动作上。不做这两个动作,查快照就只是看看。
动作一,接手一个老域名之前,看它被谁用过、历史上放过什么内容。动作二,盯一个竞品的时候,把两个时间点的快照摆在一起,看页面结构、文案、品类词怎么变的。
第一个动作有成本,这个成本是 Google 自己写出来的。站点迁移文档里有一条要求:买来的域名要先清理干净,确认没有前任所有者留下的未处理问题。
文档接着点了两样具体的东西。一样是手动操作记录,前任留下的手动操作要处理掉,再提交重新审核请求。另一样是 URL 移除记录,尤其是整站级别的移除,要确认没有残留。
垃圾政策里另有一条专门写这件事,叫过期域名滥用:买下过期域名,主要为了操纵搜索排名,托管对用户几乎没有价值的内容。政策举的例子很具体:政府机构用过的站点上放联盟营销内容,非营利医疗慈善机构用过的站点上卖商业医疗产品,前小学站点上放赌场相关内容。
违规的站会怎样,政策里也写了:可能排名更低,也可能完全不出现在结果里。发现方式有两种,自动化系统,加上按需的人工审核,人工审核可能导致手动操作。
所以查历史快照不是出于好奇。一个域名的过去,是它的成本的一部分。买之前不看,这笔成本要在接手以后付。
网站时光机怎么用:从入口到看时间轴的 5 个步骤
入口只有 web.archive.org 一个,查询功能就在首页。
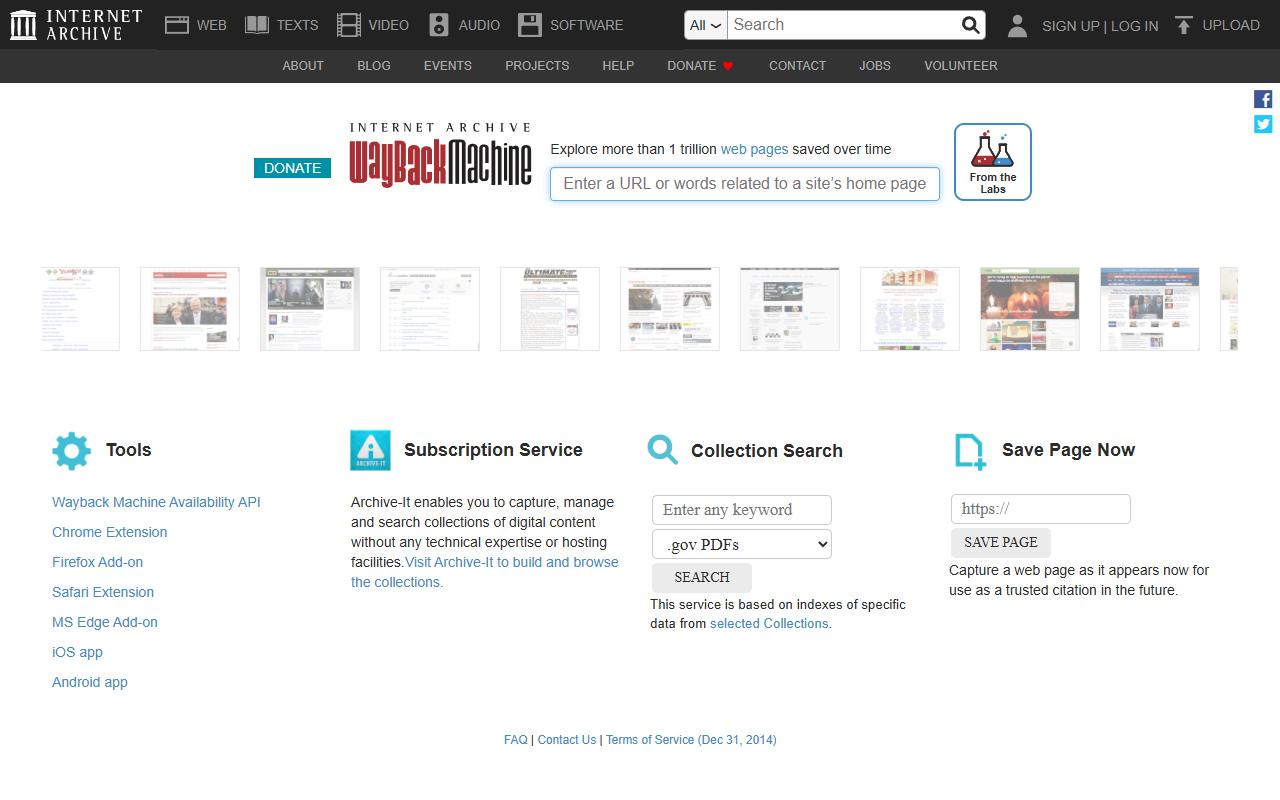
- 第 1 步,打开 web.archive.org,在首页的搜索框里输入要查的域名,回车。首页的提示是填一个有效网址。以 web.archive.org 页面显示为准。
- 第 2 步,看时间轴上有哪些年份留下了快照,圈出要查的几个时间点。不是每个站每年都被抓到,某一年空白,只说明那一年没有抓到,不代表这个站那一年没运营。要判断改版,至少圈两个相隔较远的点。
- 第 3 步,点进具体那张快照,看当时的标题、导航、品类和正文。快照存的是那一天的页面,改版前后差在哪,只有在具体页面上才看得出来。页面样式错乱是正常现象,存档不保证图片和样式表都完整。
- 第 4 步,要一次判断一批 URL 有没有存档,用 Availability JSON API。它只回答一件事:这个 URL 有没有存档,当前能不能访问。
- 第 5 步,把两个时间点的快照并排,列一张变化清单:标题改了什么,导航多了哪几项,品类词换成了什么。这张清单是后面判断的原料。只记看到的变化,不推测改版的原因。
不带时间点的写法是 http://archive.org/wayback/available?url=example.com 。要指定时间点就在后面加 timestamp 参数,例如 http://archive.org/wayback/available?url=example.com×tamp=20060101 。返回里 archived_snapshots 是空对象,说明这个 URL 未存档或当前不可访问,不是接口报错。
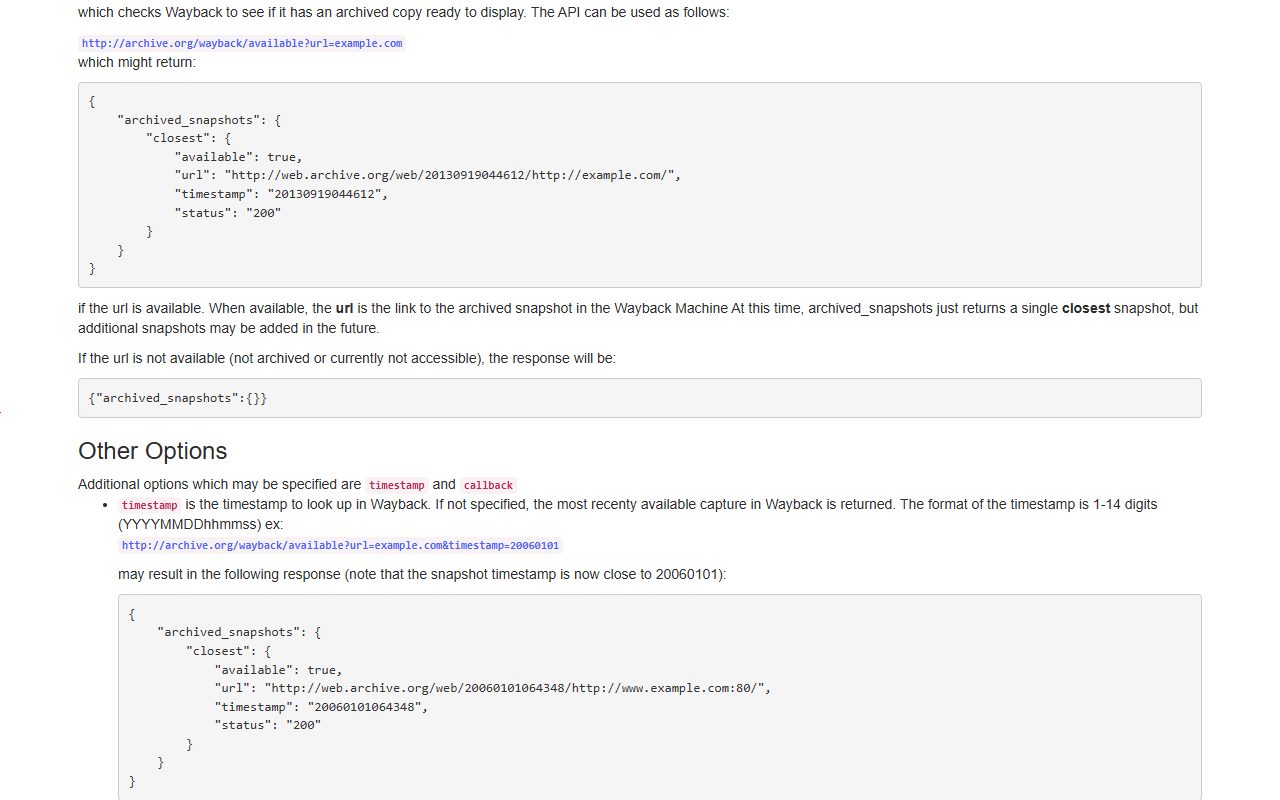
需要更复杂的查询、过滤和分析时,还有一个 CDX Server API,最新文档在 GitHub 上。普通查域名历史用不上它,批量处理很多 URL 的时候才有意义。
竞品改版背后往往跟着流量和关键词的调整。拆流量来源和关键词那篇讲的是从哪几个口子切进去看。
查老域名历史时,哪些数要记住、哪些限制要知道
能查是一回事,查得全不全看覆盖。下面几个数是动手之前该知道的。
| 要用的数 | 值 | 用在哪 |
|---|---|---|
| 可搜索网页量 | 超过 1 万亿个网页 | 判断覆盖面,别指望小站早期快照都在 |
| timestamp 格式 | 1 到 14 位数字(YYYYMMDDhhmmss) | 调 API 指定时间点 |
| 重定向链长度 | 理想不超过 3 个、少于 5 个;Googlebot 最多跟 10 跳 | 接手老域名后做跳转时用 |
| 重定向保留期 | 一般至少 1 年 | 处理旧 URL 的期限 |
前两个数决定你能查到什么,后两个数决定接手以后旧链接怎么处理。它们不是经验值,是 Google 文档里写明的规则或建议。
表里第二条是调 API 用的。查 2006 年 1 月 1 日附近的快照,timestamp 就填 20060101。后两条是接手老域名以后才会用到的,旧 URL 怎么跳、跳多久,按上面表格里的值做。
还有几条限制,用的时候会碰到。一个快照只代表那一天,站方在两次抓取之间改过什么,存档里看不到,只能从两个相隔较远的快照推断。API 一次只回一个最接近的快照,要看别的版本,得自己按不同的 timestamp 反复调。
接手老域名以后,钱怎么进出、哪些页面在带来询盘,要靠自己的后台数据看。GA4 建媒体资源那篇讲的是把数据从零建起来。
常见误区和排查:有存档不等于域名干净
这一块容易出错的地方有四个,排查的动作也有顺序。
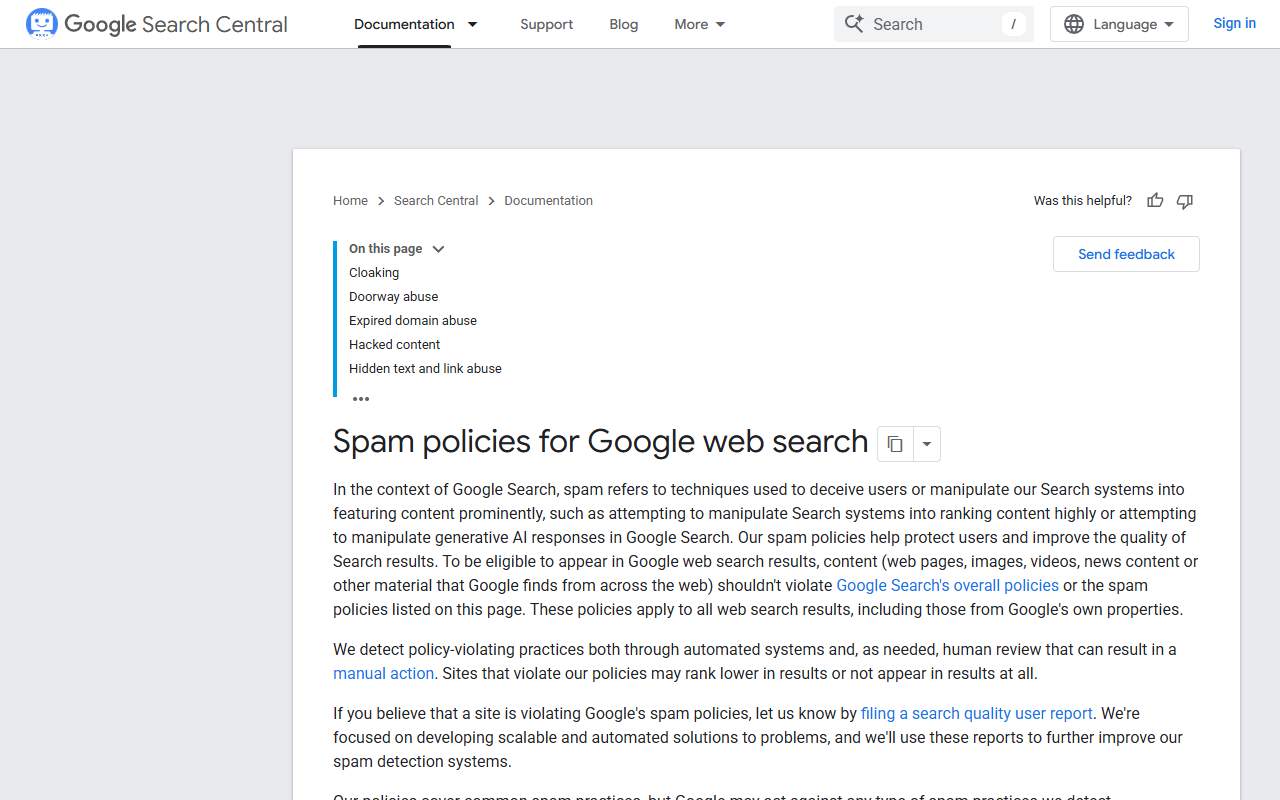
误区一:有存档,就以为这个域名是干净的
存档说明这个站的历史被人抓到过,不说明它有没有被处罚过。Google 官方讲买来的域名要查什么,清单上是两样东西:手动操作记录和 URL 移除记录。查存档不在这个清单上。
误区二:以为 API 能一次把全部历史版本拉下来
拉不下来。官方写明 archived_snapshots 目前只返回一个最接近的快照。要看别的版本,得换 timestamp 再调一次。
误区三:不填 timestamp,以为拿到的是最早那张
拿到的是最近一次可用抓取。要最早那张,回到时间轴上找最早的年份点进去。
误区四:把大量旧 URL 全部重定向到新站首页
Google 明确不推荐这么做。把很多旧 URL 指向一个不相关的单一目标,可能被当成 soft 404 处理。旧链接该对到哪,按内容对应关系一对一排。
排查的顺序是三步。先看存档时间轴,确认这个域名历史上确实有过内容和改版;再进 Google Search Console,看 Manual actions 和 Removals 两项;最后按看到的结果决定继续查还是放弃。存档只能告诉你它长过什么样,能不能接手,看的是后两项。
老域名接过手,运营上要用到的工具远不止这一件,运营必备工具清单那篇按用途列了一串。
用 AI 把快照整理成检查清单,哪 3 步能交、哪 3 件事必须人做
查一个域名,快照可能不少,API 也要调很多次。整理这一步能交出去,判断不能。
AI 能接过去做的 3 步
- 把 Availability JSON API 返回的 JSON 整理成三列表格:有没有存档、最近一次快照的时间、快照链接。它只做提取,不补 JSON 里没有的信息。
- 把两个时间点的页面正文做差异对比,列出标题、导航结构、品类词的新增、删除和改写,逐条标上属于哪个时间点。
- 把 Google 垃圾政策里跟过期域名相关的那一段摘出来,对照存档里看到的历史内容,在检查清单上做风险标注。
3 条能直接复制去用的提示词
下面三条是本文给的示例,不是官方模板,按自己的字段名改一下就能用。
第一条:「下面是一段 Wayback Availability API 返回的 JSON,请提取 available、timestamp、status、url 四个字段,输出一行表格,不要补充任何 JSON 里没有的信息。」
第二条:「这是同一个域名两个时间点的页面正文,请只列出新增、删除、改写的标题和导航项,逐条标注属于哪个时间点,不要推测改版原因。」
第三条:「这是 Google 垃圾政策中过期域名滥用一节的原文,请只摘出定义句和示例句,不要改写,不要加入你自己的判断。」
必须人做的 3 件事
- 在 web.archive.org 的搜索框里输入要查的域名,看时间轴上有哪些年份有快照,自己决定查哪几个时间点。这一步决定后面所有材料的质量。
- 在 Google Search Console 里打开这个域名的 Manual actions 报告和 Removals 记录,确认有没有前任留下的手动操作或 URL 移除。
- 看 API 返回里的 available 字段是 true 还是空对象,自己决定这个域名继续查还是放弃。
整理快照和 API 返回这一步,猎者出海的AI Agent 能接过去,它那条「动手之前:买域名前先查它的过去」正好对得上,能把时间线和风险点整理成一张单子,也挡得住买了带黑历史的域名被惩罚过这个坑。决定还是人来做。
常见问题
网站时光机的官网入口是哪个,国内能直接打开吗
入口是 web.archive.org,查询就在首页搜索框里。国内能不能直接打开,以官方为准。
网站时光机收费吗
以 web.archive.org 页面显示为准。
刚存档的网页为什么在时光机里看不到
Help Center 有一个专门条目回答这个问题,标题就是「Why can't I see the Web page I archived recently?」,按那个条目里的说明查。
网站有存档,是不是就说明这个老域名没问题
不是。存档只说明这个站的历史被人抓到过。有没有被处罚过,看 Search Console 里的 Manual actions 和 Removals。
网站时光机能查到最早的快照吗
能,回到时间轴上找最早的那个年份点进去。用 API 查的时候不填 timestamp,拿到的是最近一次,不是最早那张。
网站时光机能用来判断一个域名会不会被 Google 惩罚吗
不能。它保存的是页面过去的样子,处罚记录不在里面。要判断这件事,看 Google Search Console 的 Manual actions 和 Removals。
查历史快照这件事,做一次花不了多少时间,能省掉的麻烦在后面。工具把材料摆出来,判断自己下。猎者出海的AI Agent 能帮着把材料整理成单子,替不了这一步。

发表评论