

做英文独立站的运营手上压着二十篇产品页文案,打开四五个AI工具的价格页,一个按百万tokens标美元,一个按百万tokens标人民币,看半天不知道选哪个。这篇就把4款主流AI写文案工具的免费额度、输出判断法和单篇成本摆在一起,按预算选就行。
没有哪家官方公布过「写文案最好用」的排名,各家只公布模型、价格、计费单位和提示词写法。所以「哪个好用」得拆成三件事比:免费额度够不够跑完你的量、同一段提示词出来的稿子改几遍能用、按token单价算一篇多少钱。
对出海做站的人来说,这件事影响的是两笔账。一笔是工具费,按token算,量小的时候差不了多少。另一笔是改稿的时间,同一段提示词,有的模型出来改一两处就能用,有的出来要重写,这个差别比价格大得多。
国内能不能直接注册和付款,各家官网自己查。
- 这是什么:用同一段提示词横向比几款AI写文案工具的免费额度、输出质量和价格,按预算选工具。
- 官方怎么说:各家官方只公布模型、价格、计费单位和提示词写法,没有一家公布「写文案好不好」的评分。
- 怎么做:先定成功标准,再写第一版提示词,再按token单价算账。
- 要多少钱:按百万tokens计价,DeepSeek中文页最低0.02元/百万tokens输入(缓存命中、空闲时段),OpenAI gpt-6-astra输入$10.00/百万tokens。
- 常见误区:以为输出一定在output[0].content[0].text;以为temperature等参数还能随便调。
下面把4款主流AI写文案工具的免费额度、输出质量判断法和价格算清楚,给出按预算选的判断标准。工具分类可以对照AI工具那页,写作类软件的整体比较看写作软件哪个好用。
本文目录
先搞清楚:AI写文案软件到底在比什么
官方只公布模型、价格和提示词写法,没有「写文案好不好」的评分
打开任何一家的官方文档,能看到的是模型能做什么、按什么单位计费、提示词怎么写。Gemini可以从文本、图像、视频、音频输入生成文本输出。OpenAI的模型能生成代码、数学公式、结构化JSON数据或类人散文。DeepSeek按模型输入和输出的总token数计量计费。三家说的都是能力和计量方式,没有一家给「写文案质量」打分。
这就意味着,你在别处看到的「某款第一」都是别人的用途和别人的标准。做产品页和做博客,要的语气不一样;写英文和写中文,过的关卡也不一样。同一个人拿同一段提示词去试,结果都可能不同,更别说别人替你排的名。
所以「好用」要拆成三个可比的维度
Anthropic的提示词工程文档里提了一句判断:有些成功标准和失败的评估,靠改提示词解决不了,换个模型反而更容易把延迟和成本降下来。这句话放到选写文案工具上同样成立。同一段提示词在A模型上改三遍才过,在B模型上改一遍就过,那B对你就是更省的那个,跟模型参数多大没关系。
三个维度就清楚了:免费额度够不够跑完你的量、同一段提示词下的输出要改几遍、按token单价算下来一篇多少钱。前两个决定你用起来顺不顺,第三个决定量大了以后花多少。
用了它能带来什么
OpenAI的文档给提示词工程下的定义是:「给模型写有效指令,让它稳定生成符合要求的内容。」「稳定」两个字是重点。写文案用AI,省下来的不是从零写到成稿的那几个小时,是同一篇稿子反复改的那几轮。提示词写对了,第一版出来就有大半能用,你只改剩下那部分;提示词没写对,每版都要重来。
一款工具好不好用,最后落到你改几遍。改得少的那款,单篇成本再高一点也值;改得多的那款,免费额度再大也是浪费你的时间。
市面上的AI写文案软件分几类,各适合谁
对话类和免费体验入口
豆包、千问、DeepSeek、Kimi、腾讯元宝、智谱清言、文心一言都属于对话类。打开网页就能用,不用配API key,适合先把同一段提示词丢进去看输出。Google AI Studio是Google给开发者的免费体验入口,可以先用它跑Gemini的提示词,试完觉得输出能用,再决定要不要上付费层。
适合一次写几篇、想先看效果再决定要不要接API的人。不适合一天要出几百篇、需要把生成过程嵌进自己系统的人。网页端一次贴一段、点一次运行,量大了手动操作跟不上。
API类
OpenAI、Anthropic、Google Gemini、DeepSeek都提供API。按token计费,写多少算多少,适合批量写。DeepSeek的计费口径是输入和输出的总token数,不按调用次数。API类的好处是能把提示词、成功标准、输出格式固定下来,跑批量任务时不用每次手动点。
API类还有一个好处是usage能直接拿到。每次调用返回输入、输出、总token数,你把四个模型的数字抄到同一张表里,单篇成本就出来了。这是网页端做不到的。
聚合平台类
OpenRouter这类平台,一个接口可以调500多个模型。横向比价的时候,不用为每个模型单独开一个账号、单独充一次值。缺点是中间多了一层,价格和可用模型以平台页面为准,你比自己直接对接官方多一个变量。
适合先用来做一轮粗筛:同一段提示词发给几个模型,看哪两三个输出顺眼,再拿这两三个去官方API上做正式对比。粗筛阶段用聚合平台省事,正式算账还是按官方单价来。
出海写文案,先定「成功标准」再选工具
第一步:把成功标准写成可检验的清单
Anthropic的提示词工程指南开头就写,它假设你手上已经有三样东西:清晰的成功标准定义、按标准做实证测试的办法、一版想改进的提示词草稿。第一样是地基。没有它,你没法判断A模型的输出比B模型好在哪里,只能说「感觉A顺眼一点」。
成功标准要写成能打勾的条目。比如「是否包含品牌名」「是否出现禁用词」「字数是否在区间内」「有没有行动号召」。每条能用是或否回答,才叫可检验。写成「语气要专业」这种,两个人都能说自己对。
出海文案的清单长什么样
按出海产品页和博客的用途,清单一般有五条:字数、语气、是否含行动号召、是否含禁用词、是否保留品牌名。这五条覆盖了一篇文案交付前要过的关卡。你把这五条写进提示词,模型每次生成完,你按这五条逐项打勾,改了几处一眼能看出。
五条里最容易漏的是品牌名和禁用词。有的模型会把品牌名改写成同义词,有的会带出你不想用的行业套话。这两条不写进提示词,输出看着顺,拿去用就出问题。
为什么先定标准再选工具
标准定了,你才知道哪款改得少。同一段提示词,A模型五条里过四条,B模型五条里过两条,那A对你就是更合适的,不用再看参数表。Anthropic那句判断在这里也适用:有些失败不是提示词的问题,是模型选错了。先有标准,你才分得清是提示词要改,还是该换一款。
把五条标准写成提示词的具体格式,可以参考提示词五段式模板。模板管格式,五条标准管内容,两样都齐了再去比模型。
同一段提示词横向比4款工具,怎么比才公平
第二步:写第一版提示词
Anthropic的指南假设你有一版想改进的草稿。没有草稿的话,它给了一个办法:用Claude Cookbook里的metaprompt配方先生成一版。有了第一版,后面才有得改。第一版不用追求完美,把任务、输出格式、五条成功标准写进去就行。
写第一版的时候,输出格式要定死。是纯文本、JSON还是带小标题的段落,先写清楚。格式不定,四个模型返回的结构都不一样,你没法并排比。
用system_instruction / instructions固定语气和目标
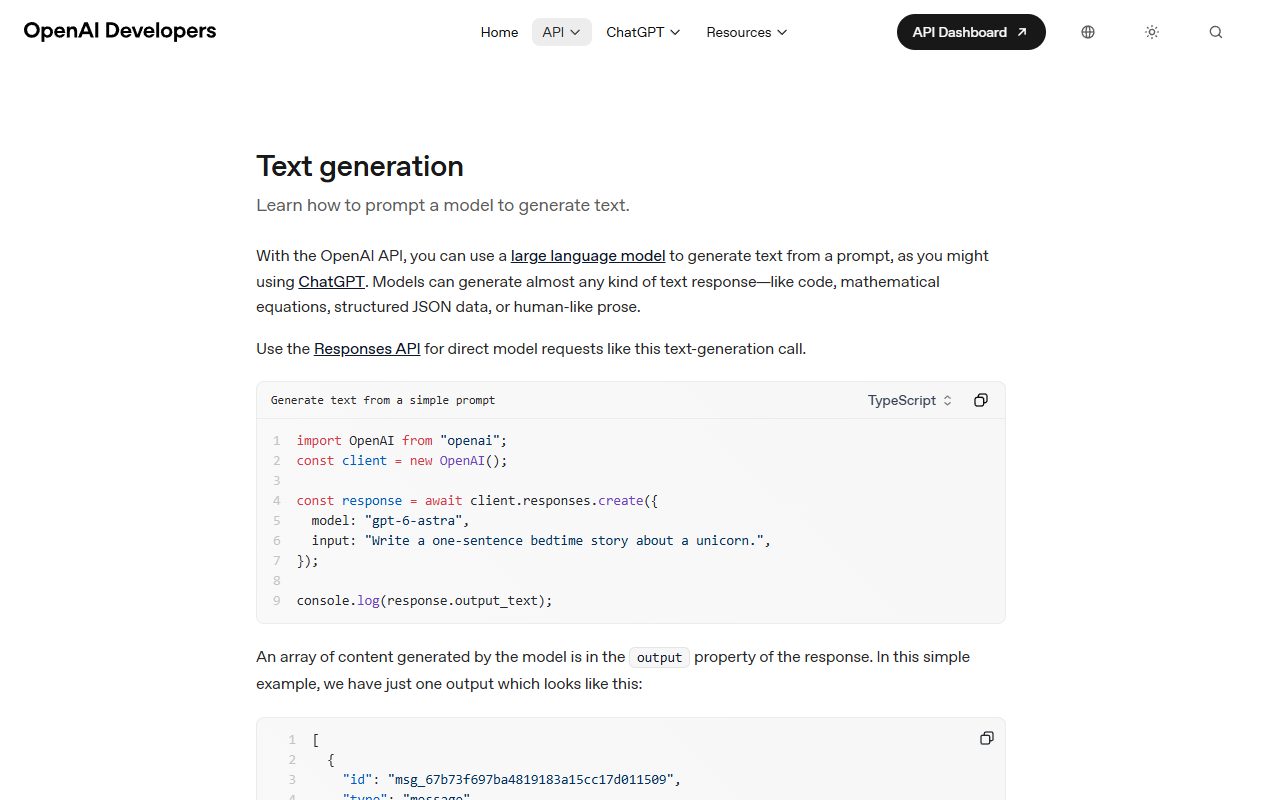
Gemini可以用system_instruction参数配置模型行为。OpenAI的instructions参数给模型高层指令,包括语气、目标和正确回答示例,优先级高于input参数里的提示词。把语气和目标放在这一层,比塞在用户消息里更稳。
OpenAI的instructions只对当前这次请求生效。用previous_response_id管理对话状态时,之前轮次的instructions不会出现在上下文里。这一点在连续写多篇文案时要留意,别以为设一次就一直在。
同一段提示词分别投给4款,把输出并排贴出来
提示词固定,模型换四个,其他条件不变。输出拿到后并排贴在一张表里,按五条标准逐项打勾。这一步比的是同一段提示词下谁更接近你的标准,跟名气没关系。
并排看的时候只看两件事:哪几条标准没过,过了的那几条读起来顺不顺。没过的条目记下来,是提示词没写清楚,还是模型理解不了,这个区别决定你下一步改哪里。
每款自报token数
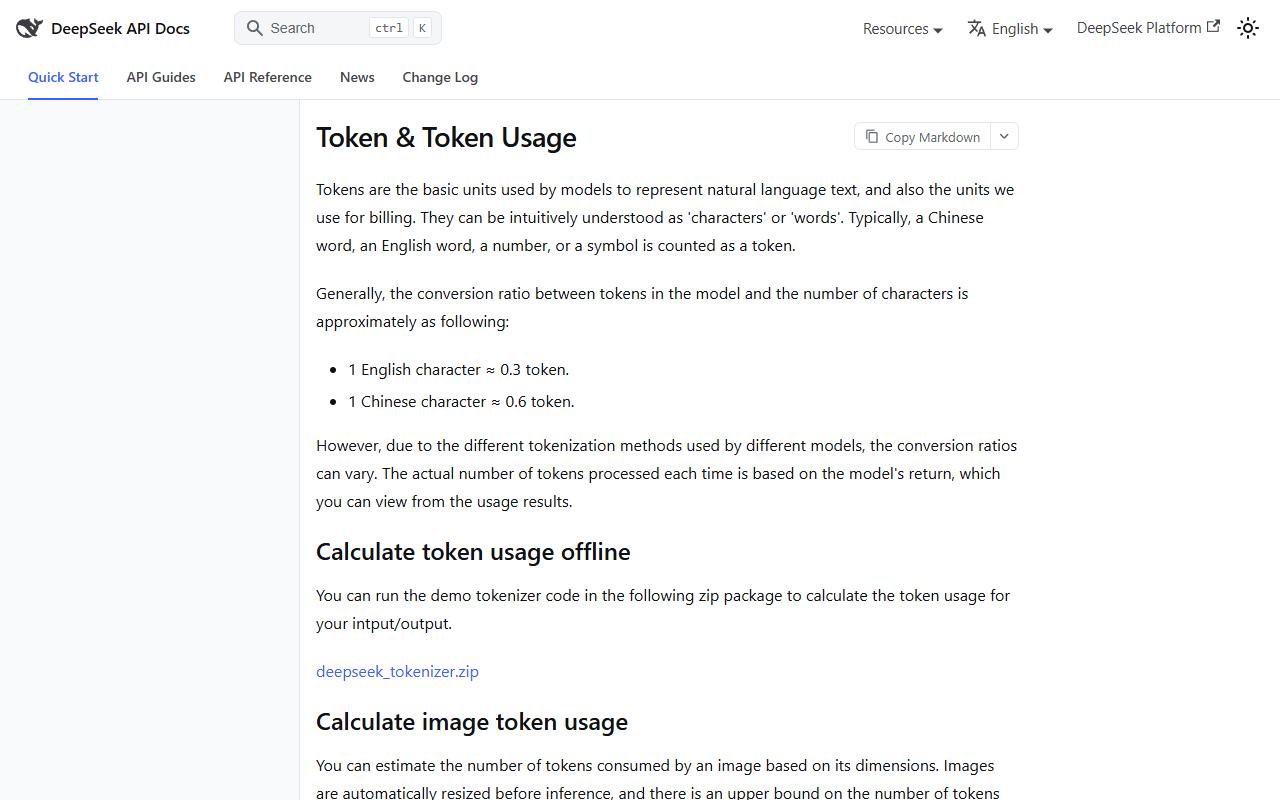
实际token数以模型返回为准,可以从usage结果查看。每家API返回的usage字段名不一样,但都会给输入、输出、总数。你把四个模型的usage抄到同一张表里,单篇成本就能算出来。
抄的时候别只抄总数。输入和输出单价常常不一样,分开抄才能按各自的单价算。
出问题怎么回查
OpenAI的文档提醒,输出数组常不止一项,可能含工具调用、推理模型生成的推理tokens,不能假定模型文本输出就在output[0].content[0].text。拿不到文本,先打印整个输出看结构。
Gemini这边,.output_text不包含被非文本内容隔开的更早文本块,比如thoughts、图像、音频或工具调用。复杂或多模态交错的响应,要手动遍历steps。无状态对话模式下,模型用了thinking或工具,必须原样保留并重发所有模型生成的步骤,因为它们含继续对话所需的签名。英文稿的提示词怎么写,可以参考AI写英文SEO稿。
免费额度怎么用:免费层和付费层差在哪
Gemini免费层和付费层的区别
Gemini免费层提供免费输入和输出tokens,但只能有限访问部分模型。付费层给生产部署更高的速率限制。免费层先跑几篇,看你一天的用量够不够,不够再上付费层。
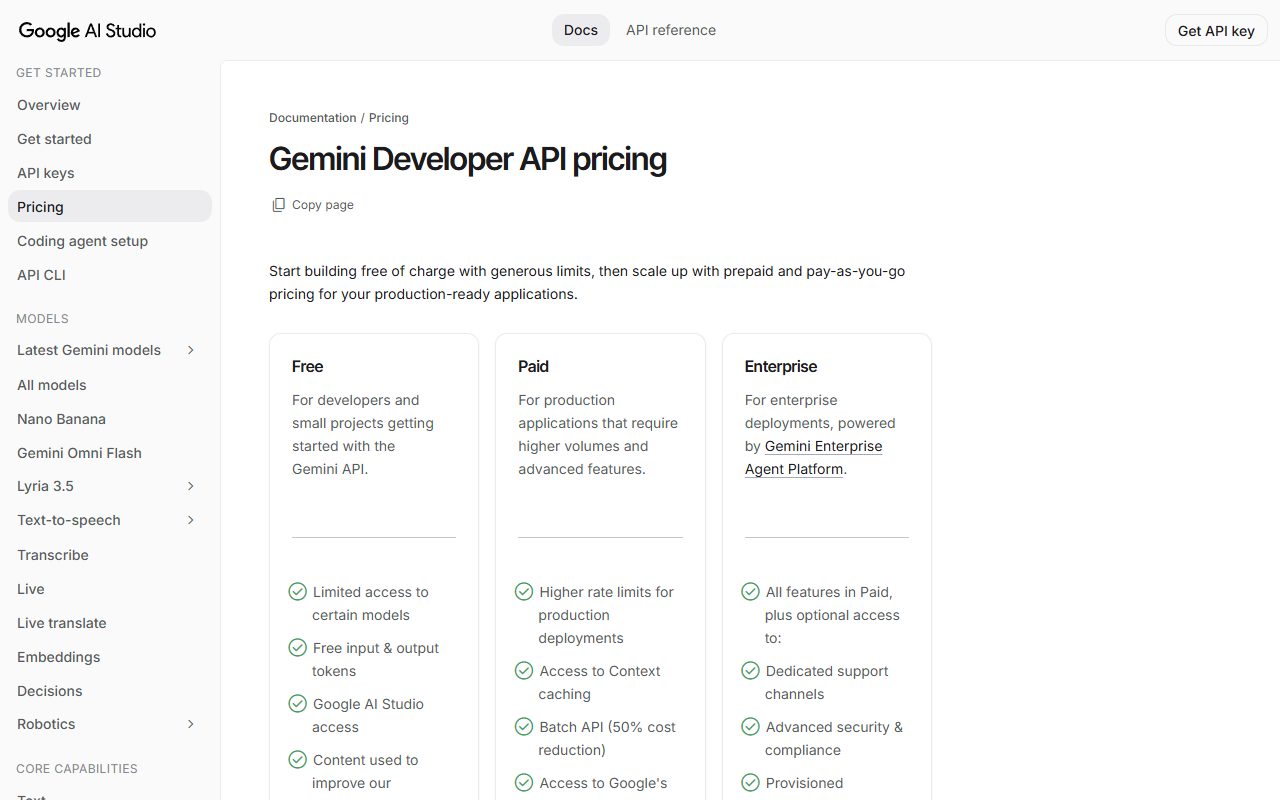
付费层买的不是模型能力,是速率和稳定性。免费层限量访问,跑批量任务时容易卡在速率上。你的量如果一天就几篇,免费层够用;一天几十上百篇,付费层的速率限制才是你要的。
免费层的内容会被用于改进产品
Gemini免费层的内容会被用于改进产品,付费层内容不用于改进产品。出海商用文案如果是给客户写的、或者含未发布的产品信息,这一条要先看清楚。免费层适合试提示词、跑草稿,定稿和商用稿走付费层更稳。
这条规则不只影响Gemini。用任何免费层跑商用稿,先看那家的条款怎么写。写文案的稿子里常有还没上线的产品名、价格、卖点,这些内容进了哪一层的处理流程,值得花五分钟翻一下。
Carbon和Argon不在免费层提供
Gemini 4 Carbon和Gemini 4 Argon不在免费层提供。模型处理的每个token都计费,包括thinking tokens,以及用grounding时的内部工具系统指令和函数声明。想用这两个型号,先按付费层的价格算一遍成本再决定。
thinking tokens是容易被忽略的一项。模型在回答前先推理,推理过程也算token。你用这两个型号写文案,账单上的数字会比按输出字数估算的高。
国内工具先在网页端试
国内几款对话类工具,网页端打开就能用。同一段提示词在网页端跑一遍,看输出能不能过你的五条标准,过了再考虑接API。这样试的成本是零,比先充值再试划算。文心一言的具体表现,可以看文心一言测评。
网页端试还有一个用处:先看模型懂不懂你的行业。有些模型对某个品类的表达习惯不熟,输出里全是外行话,这种试一次就能看出来,不用等到接了API才发现。
按token单价算账:一篇出海文案到底多少钱
先换算
DeepSeek的换算比例是:1个英文字符约0.3 token,1个中文字符约0.6 token。按这个比例,一篇1000字的中文文案,输出约600 tokens。
输入部分别漏算。提示词、成功标准、示例稿都要算进输入。提示词写得长,输入token数就跟输出差不多,算成本时两边都要算。
四款工具单篇成本对照
下面这张表只放算账要用的数。单价按每百万tokens,最后一列按600 tokens输出算。
| 工具/模型 | 输入单价(每百万tokens) | 输出单价(每百万tokens) | 600 tokens输出约 |
|---|---|---|---|
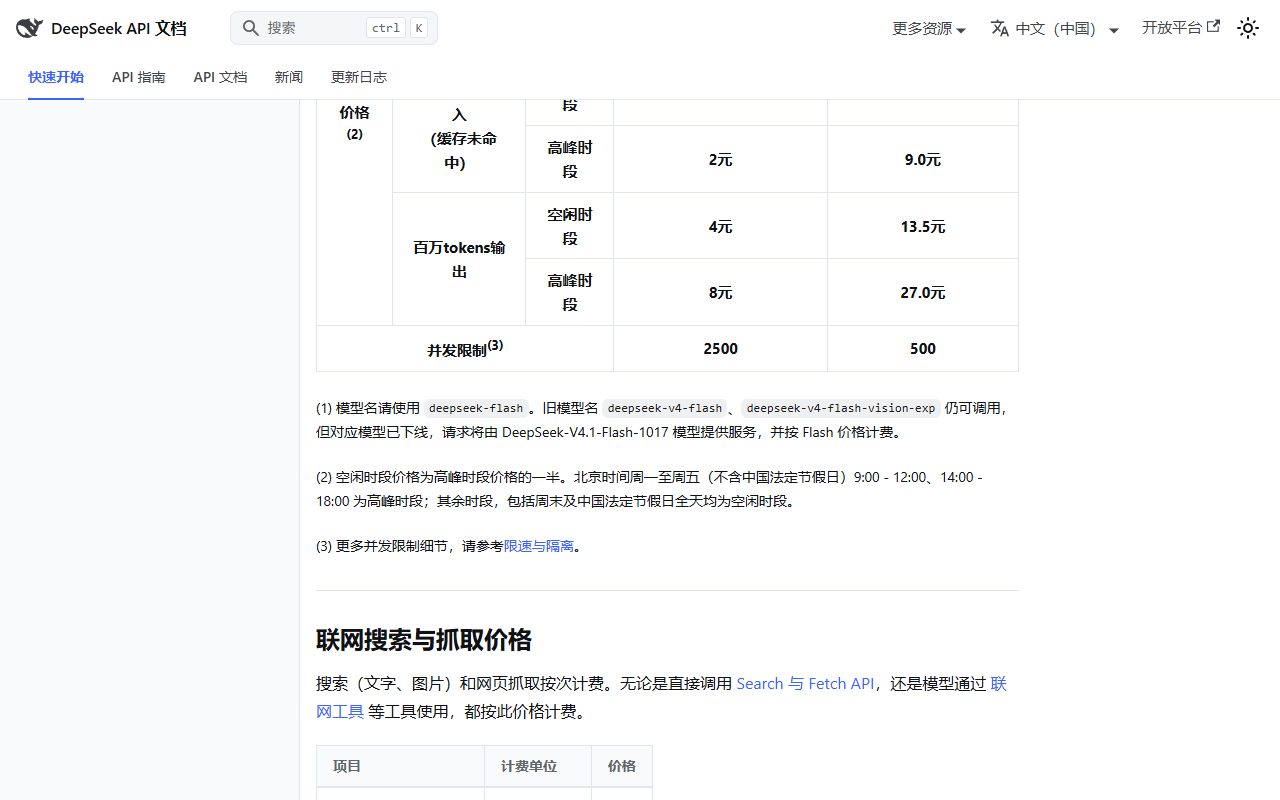
| DeepSeek deepseek-flash(空闲时段) | 1元(缓存未命中)/ 0.02元(缓存命中) | 4元 | 约0.0024元 |
| OpenAI gpt-6-astra | $10.00 | $50.00 | 约$0.03 |
| OpenAI gpt-6-luna | $0.10 | $0.50 | 约$0.0003 |
| Claude Sonnet 5.5 | $2/MTok | $10/MTok | 约$0.006 |
表里DeepSeek按人民币计,OpenAI和Claude按美元计,先换成同一种货币再比大小。量小的时候差几十块钱感觉不出来,一天出几百篇的时候,选哪款直接决定这个月的工具账单。表里列的是有官方单价的型号,Gemini的单价按官方定价页当时的显示为准。
省钱的三条路
DeepSeek的空闲时段价格是高峰时段的一半。北京时间周一至周五(不含中国法定节假日)9:00到12:00、14:00到18:00是高峰时段,其余时间包括周末和法定节假日全天都是空闲时段。批量任务排到空闲时段跑,单价直接减半。
Claude的Batch API输入和输出tokens均打5折。适合不急着当天要稿的批量任务。Gemini付费层的Batch API也能降50%成本。这两家的折扣都要求走异步批处理,不是实时对话。
扣费顺序
DeepSeek的扣费规则是:充值余额与赠送余额同时存在时,优先扣减赠送余额。你在后台看余额,要看这两项,别只看总数。赠送余额先用完,后面才动充值的钱。
腾讯元宝的免费额度可以看腾讯元宝免费额度,通义千问的API计价看通义千问API价格。这两家的计价口径跟前面几家不一样,算账时单列。
AI能帮你做完哪几步,哪几步必须人来
AI能帮的4步
- 按Anthropic的要求,先把成功标准写成可检验的清单,再据此起草第一版提示词。
- 用同一段提示词分别投给几款模型,把各自输出并排贴出来做对照。
- 按各家官方token单价和官方换算比例,把每款工具的单篇成本算出来。
- 把各模型返回的usage数字整理成一张对比表。
这四步里,重复的整理和计算可以交给工具做。几款模型的输出并排贴出来之后,选中的那版英文稿还要按目标市场做本地化,把美式说法改成当地读者习惯的表达,猎者出海的AI Agent 写作编辑那块能接这段。哪版能用、哪版要重写,还是你自己判断。
人必须做的3件事
- 在Google AI Studio、OpenAI Playground、DeepSeek Platform各自后台填入同一段提示词并点运行,把返回的usage数字抄下来。
- 在DeepSeek Platform看充值余额与赠送余额两项,确认扣的是哪一笔。
- 看各模型返回的usage结果决定去留:实际token数与预估差得多的那款,换下一档模型再试一次。
3条可照抄的提示词
下面三条是本文给的示例,不是官方模板。复制到工具后台改一改就能用。
- 「下面是一段出海文案提示词。请先列出5条可检验的成功标准(字数、语气、是否含行动号召、是否含禁用词、是否保留品牌名),再据此改写提示词,只输出改写后的提示词。」
- 「用下面这段提示词分别生成一版英文产品文案,输出后自报:总token数、输入token数、输出token数。提示词:<粘贴同一段提示词>」
- 「按这张价格表(模型名、输入单价、输出单价、单位)和这次的实际token用量,逐款算出单篇成本,列成表格,保留原始单位不换算。」
常见误区和排查:这5个坑先避开
误区一:以为模型文本输出一定在output[0].content[0].text。OpenAI的文档明确写,不能假定模型文本输出就在这个位置,输出数组常不止一项,可能含工具调用、推理模型生成的推理tokens。拿不到文本,先打印整个输出看结构。
误区二:以为temperature、top_p、top_k还能随便调。Gemini 4和Gemini 3.6+模型会忽略这三个参数的自定义值并返回弃用警告头,官方要求从请求里移除。你调了没效果,不是模型坏了,是这几个参数在新模型上不生效。
误区三:无状态对话模式下没保留模型生成的thinking或function_call步骤。Gemini这边,模型用了thinking或工具,必须原样保留并重发所有模型生成的步骤,因为里面含继续对话所需的签名。少发一个,下一轮就接不上。
误区四:Claude早期模型带inference_geo参数返回400错误。Claude早期模型不支持这个参数,总是用标准价,带该参数的请求返回400错误。用老模型的时候把这个参数去掉。
误区五:以为旧模型名还能按旧价用。DeepSeek的旧模型名deepseek-v4-flash、deepseek-v4-flash-vision-exp仍可调用,但对应模型已下线,请求由DeepSeek-V4.1-Flash-1017提供服务,按Flash价格计费。看到旧名字别按旧价格算账。
排查顺序:先看usage返回了没有,再看输出结构对不对,再看参数是不是被忽略,最后才换模型档位。这个顺序能少花时间,因为越靠前的可能性越大。
常见问题
ai写文案软件有官方排名吗?
没有。各家官方只公布模型、价格、计费单位和提示词写法,没有一家公布「写文案好不好」的评分。所以「哪个好用」只能按你的用途和预算自己比。
免费额度够写多少篇?
Gemini免费层提供免费输入和输出tokens,但只能有限访问部分模型,具体能写多少篇按你的提示词长度和输出长度算。国内几款对话类工具先在网页端试,跑几篇看够不够。
一篇1000字中文文案大概多少token?
按1个中文字符约0.6 token换算,约600 tokens输出。这是输出部分,输入部分要把提示词的长度也算进去。
DeepSeek和OpenAI单篇成本差多少?
按600 tokens输出算,DeepSeek空闲时段约0.0024元,OpenAI gpt-6-astra约$0.03。一个按人民币一个按美元,换成同一种货币再看差距。
出海商用文案用免费层要注意什么?
Gemini免费层的内容会被用于改进产品,付费层内容不用于改进产品。商用稿和含未发布信息的稿子走付费层更稳。
国内工具能不能直接用?
国内几款对话类工具可以打开网页端试同一段提示词,不用先配API。试完看输出能不能过五条标准,再决定要不要接API。
AIGC和AI写文案是一回事吗?
AIGC的范围更大,AI写文案是其中一类。概念的区别可以看AIGC是什么。
把这套流程跑一遍,你手上会有一张自己的表:四款工具、同一段提示词、五条标准、四个usage数字、算出来的单篇成本。哪个好用不用别人告诉你。后面量大了,成稿和本地化这些重复活可以交给猎者出海的AI Agent,选哪款、改哪版还得你自己定。

发表评论