
同一份输出量,用GPT-6 Astra和用GPT-6 Luna,成本差100倍。Astra每100万输出tokens收1250 credits,Luna同样100万只收12.5 credits,这组数字来自ChatGPT Business/Enterprise/Edu的信用费率表。所以国外做ChatGPT应用开发赚美金这件事,真正卡人的地方不在会不会写代码,在你账号能不能合规用、模型有没有选对。官方支持地区页逐条列了名单,未见China、Hong Kong,在名单之外访问或提供访问,可能导致账号被封禁或暂停。
你把API包成应用卖给老外,成本这头按token走,收入那头客户直接付你,OpenAI不抽你的成,也不给你导流。它只做两件事:收你的用量费,按条款管你的账号。所以这句话要拆开看,赚的是你交付给客户的那部分钱,不是平台分给你的钱。
- 平台:OpenAI API,官方文档写的是用OpenAI API在ChatGPT和Codex里构建,面向开发者
- 地区:官方支持地区名单未见China、Hong Kong;名单外访问或提供访问可能导致封号或暂停
- 计费:API按token计费;2023年公告gpt-3.5-turbo每1k tokens 0.002美元、Whisper每分钟0.006美元
- 用量层级:Free每月100美元额度;Build累计买5美元信用;Launch累计买100美元;Grow累计买500美元
- 支出控制:可设Spend alert只发通知,或Hard spend limit触发后受影响请求返回429
下面讲清这条线是什么、按官方规则能不能做、从建key到上线的分步、费用怎么算、钱怎么收、条款里哪些动作会封号。方向和选品上的事,站内项目栏目 /xiangmu/ 里有更宽的整理。
本文目录
这个项目是什么、钱从哪来:卖的是「用API做出来的应用」,不是卖API本身
钱来自两头。一头是给老外做定制应用或接单开发,收服务费;一头是把做出来的工具做成订阅或一次性买断的产品。OpenAI在这两头都不参与分钱,它只按token收你的成本。这两个角色分清了,账才算得明白。
官方文档列了三条构建路径。Responses API用来直接发模型请求,覆盖文本、结构化输出、工具和多模态工作流。Agents SDK用来构建代码优先的智能体,编排工具、交接、审批、追踪和容器化执行。Models这一栏列了四款:GPT-6 Astra定位最强,用于要求最高的活;GPT-6.1 Sol定位接近Astra的性能、更低成本,用于复杂工作;GPT-6.1 Terra列在名单里;GPT-6 Luna定位最高效,用于聚焦的高并发任务。选路径就是选你交付的形态,选模型就是选你的成本档位。
能做的活按官方能力对号,大致四类。接单开发,用Responses API交付一个具体功能,比如把一段产品描述转成结构化卖点。SaaS工具,用结构化输出加多模态做成可订阅的小工具。提示词或模板类产品,把Structured Outputs的JSON schema做成可复用件。插件集成,官方文档写可扩展ChatGPT,为ChatGPT和Codex构建插件。这四类都有官方能力撑着。
成本结构很简单:你的成本是token和信用,你的收入是客户付你的钱,中间没有平台抽成。OpenAI不是接单平台,不代收不代付。所以这个项目赚不赚,不取决于平台分你多少,取决于你卖什么价、成本控到什么程度。定价页只写“Start creating with OpenAI's powerful models”,具体单价页没抓到,能核的是2023年公告的两个价和历史信用费率,后面单独一节算。
出问题怎么回查。先看官方文档的Build paths一节,确认自己用的是哪条路径,别把Responses API和Agents SDK的示例混着抄。再对照模型定位选模型:重活上Astra,性价比上Sol,高并发上Luna。模型选错,同一份用量成本差100倍,开头那组费率就是这个意思。
做定制GPT应用这条路,站内 /guowai-dingzhi-gpt-zhuanqian/ 讲得更细,可以对照着看自己适合接单还是做产品。把官方条款和文档原文整理成一张对照表,哪些动作会封号还得自己逐条看原文。
中国人能不能做:官方名单里未见中国大陆,名单外访问「可能导致账号被封禁或暂停」
按官方原文,能不能做取决于你是否在支持地区名单内。官方帮助中心写,名单列出的是“我们目前支持访问的国家、地区和领土”。名单逐条列出,未见China、Hong Kong。官方没有就中国大陆单独表态,这条以官方为准。
名单外访问的后果,官方写得很直白:在名单之外访问或提供访问服务,可能导致账号被封禁或暂停。这句话管两头,自己访问算,给别人提供访问也算。你把API包成应用卖给名单外的客户,这条同样适用。所以这不是注册时躲一下的问题,是整个交付链条都要放在名单内看。
注册的硬条件在条款里。须年满13岁或所在国家同意使用服务的最低年龄;未满18岁须父母或法定监护人许可;须提供准确完整的信息;不得共享账号凭证,也不得把账号提供给他人,账号下发生的所有活动自己负责。这几条里,共享凭证和账号外借最容易在接单场景里踩,客户说借你账号跑一下,借出去就违规。
付款的硬条件也在条款里。购买服务须提供完整准确的账单信息和有效付款方式;付费订阅会在每个约定续费周期自动扣款,直到你取消;付款无法完成时,OpenAI可能降级账号或暂停服务访问,直到收到付款。做应用要长期跑,付款方式断掉,服务就断,客户那边的交付也跟着断。
免费层级也带地区条件。官方速率限制页写Free层级要求用户处于允许的地理区域,每月额度100美元。免费不等于没门槛,地区这一条对免费层级同样成立。
判断路径就两条:先查官方支持地区页,看自己在不在名单内;再看条款里的账号要求和付款要求能不能满足。两条都过,再谈做不做。不用API、只用ChatGPT本身赚钱的方法,站内 /chatgpt-zhuanqian-fangfa/ 有整理,可以先看那条线。
官方支持地区页和条款页会更新,把原文抓下来逐条对照这件事,可以交给猎者出海的AI Agent做整理,结论自己下。名单这种东西,别人转述的版本不能当依据。
怎么开始:从登录平台到建出第一个API key,再到设支出上限
官方给的最短路径是三步:用OpenAI账号登录平台,创建API key,设支出上限。平台首页写的是用OpenAI账号注册或登录,就能在API平台上构建。文档的“Get started”第一步就是Create API key。这三步没做完,后面写什么代码都是空转。
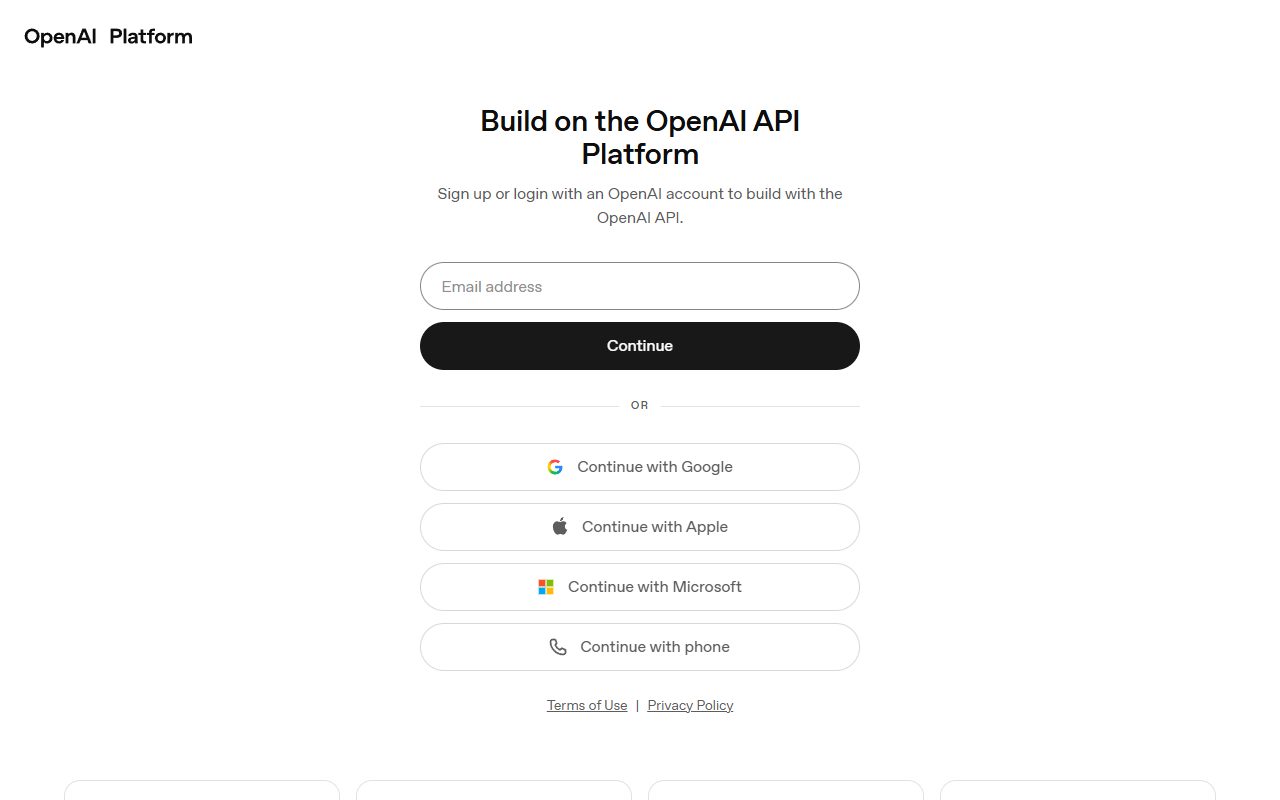
第一步,打开platform.openai.com,用OpenAI账号注册或登录。登录方式包括邮箱、Google、Apple、Microsoft、手机号。这一步的界面和流程会变,以官方页面为准。别照着几个月前的截图一步步点,按钮位置和验证方式都可能不一样。
第二步,按文档的“Get started”创建API key。请求时用Authorization Bearer头携带key,示例里是从环境变量读。你自己写代码时也照这个来,key从环境变量读,不硬编码。理由很实在:key写进代码,代码一旦给别人看、传到公开仓库、发给客户做演示,等于把账户交出去。条款里账号下所有活动自己负责,key泄露产生的用量也算你的。
第三步,到Settings > Organization > Limits看自己层级的速率限制。官方写速率限制按组织级和项目级定义,不按用户级。这句话的意思是,你一个人开几个项目,额度是按组织和项目算的,不是按每个登录用户分。接单给客户做演示,别拿主项目的key去跑测试流量。
第四步,设支出上限。官方给两个选项:Spend alert只发通知,API流量继续;Hard spend limit触发后,受影响的API请求返回429。先设上限再写代码,调试期最容易把额度烧穿。调试的特点是请求小但次数多,循环里忘了停,一晚上跑掉的量可能比上线第一周还多。
第五步,需要更高额度时,在Usage Tiers区域选Upgrade tier。用量层级随组织累计信用购买额达到阈值自动升级:Build门槛是累计买5美元信用,Launch门槛是累计买100美元,Grow门槛是累计买500美元。官方原话的意思还有一层:达到用量层级门槛,不等于拿到所有模型的访问权,模型访问和速率限制是分开的。升了层级,先确认你要用的模型在不在你的访问范围内。
注册页的完整分步、账单后台的具体界面、充值步骤,都要登录后才能看。别把网上抄来的旧流程当标准,尤其是付款和开票的入口,改版很频繁。
怎么做:选方向、做出来、上架、引流,四步各自的动作和回查点
先选一条官方能力撑得住的方向,把最小可用版本做出来,再谈上架和引流。四条方向里,接单开发回款最快;SaaS工具最慢,但做出来能反复卖。你先想清楚自己要快钱还是要可复用的东西,再动手。
第一步选方向,按官方能力清单对号。官方文档列的能力有:读写文本、视觉分析图像、用GPT Image 2生成图像、音频分析转写生成、构建使用工具和计算机的智能体、用推理模型执行复杂任务、结构化输出、微调与评估。你选一个能交付具体结果的。反例是“做个万能助手”,交付物说不清,客户没法验收,你自己也没法判断做完没有。正例是“把一段产品描述转成标题、三条卖点、目标人群”,输入输出都能写清楚,做完就能演示。
第二步做出来,用Responses API发请求。要可解析的结果,就用Structured Outputs按JSON schema返回,官方写的是让模型响应符合JSON schema。要多步流程,就用Agents SDK拆工具、交接、审批。最小可用版本的意思是:一个输入框、一次模型调用、一个能看懂的输出,先跑通。别一上来做登录、做支付、做后台,那些是上架之后的事。
做出来这一步最容易出的问题是输出格式不稳。同一段输入,模型这次返回三行,下次返回一段话,你的程序解析不了。解法是把字段写进schema,让模型按结构返回,程序只认结构。schema里字段别贪多,先三到五个,跑稳了再加。
第三步上架。官方文档写可扩展ChatGPT,为ChatGPT和Codex构建插件。插件市场、SaaS平台、提示词市场的抽成与结算规则,以各平台官方页面为准。上架前先看三件事:平台收什么费、什么时候结算、退款怎么算。这三条看不清就先别上,上了也是给平台打工。
第四步引流。官方给的资源位有三个:开发者论坛可以和其他开发者讨论话题,Cookbook是开源示例与指南合集,状态页可以查看OpenAI服务状态。这三个不是流量入口,是你排问题和找示例用的。引流的路子要自己按产品去找,官方文档里没有给你导流这一项。
出问题怎么回查,官方给了排查顺序。模型缺失时,先核对模型ID和端点,用文档里的准确ID,确认它支持你的端点,再看有没有退役或可用性通知;然后比对组织、项目和凭证是不是对得上;再检查项目限制和模型要求;最后刷新后重试。联系支持时不要分享API key。这个顺序别跳,跳步最容易把配置问题当成模型问题。
四条方向对号入座:接单开发对Responses API,SaaS工具对结构化输出加多模态,提示词模板对Structured Outputs的schema,插件集成对“Extend ChatGPT”。每条都有官方能力撑着。站内 /chatgpt-zhuanqian-zhinan/ 讲的是把ChatGPT用在出海业务场景里的另一组做法,可以和这四条对照。
能赚多少、费用和抽成:官方只收你的token钱,赚多少取决于你卖什么价
这个项目没有“平台给你发钱”这一环。官方定价页只写“ChatGPT API Start creating with OpenAI's powerful models”,具体单价页没抓到。能核的是2023年公告的两个价和历史信用费率。所以“能赚多少”这个问题,官方给不了答案,它只告诉你成本怎么算。
| 项目 | 金额 | 条件 |
|---|---|---|
| gpt-3.5-turbo | 每1k tokens 0.002美元 | 2023年公告价 |
| Whisper API | 每分钟0.006美元 | 2023年公告价 |
| 专用实例 | 每天约4.5亿tokens以上才有经济意义 | 2023年公告 |
| GPT-6 Astra | 输入250、缓存输入25、输出1250 credits每100万tokens | Business/Enterprise信用费率表 |
| GPT-6 Luna | 输入2.5、缓存输入0.25、输出12.5 credits每100万tokens | 官方费率表 |
| Codex | 约100到200美元每位开发者每月 | 官方说明,随模型与并发变化大 |
| Fast / Ultrafast | 使用 credits 时,标准费率2倍 / 6倍 | 官方费率表 |
表里能直接当成本用的,是2023年公告的两个价;信用费率来自ChatGPT Business/Enterprise/Edu的费率表。专用实例那条是门槛,不是单价,每天跑不到那个量,用专用实例不划算。Codex那条是给用Codex的人的参考,不是API调用的必须成本。
按token计信用时,官方给的公式是:总信用等于输入tokens除以100万乘输入费率,加缓存输入tokens除以100万乘缓存费率,加输出tokens除以100万乘输出费率。官方还写,实际信用用量随模型、任务复杂度、输入大小、缓存输入、输出长度、自动化和快速模式变化。所以同一段代码,换个模型、加个自动化,账单能差出好几倍。
下面这个算例是按ChatGPT Business/Enterprise/Edu信用费率表的假设,不是行情,也不是谁的账单。假设一个应用每月处理1000万输入tokens加200万输出tokens,全用GPT-6 Luna:10乘2.5加2乘12.5等于50 credits。换成GPT-6 Astra:10乘250加2乘1250等于5000 credits。同一份用量,模型选错差100倍。这个差距不是折扣能补回来的,是选型阶段就该定下来的事。
抽成这一块要说清:OpenAI不对你的收入抽成,它只收你的用量费。接单平台、SaaS平台的抽成,以各平台官方页面为准。所以别把“平台抽成”当成这个项目的主要成本,你的主要成本是token和信用,加上你自己获客的钱和时间。
涨价与退款在条款里。订阅涨价会提前至少30天通知,涨价在下次续费时生效,你可以选择取消。付款除法律要求外不予退款。做长期产品要把这两条算进去,涨价通知期是30天,足够你调价或换方案。
Fast和Ultrafast的倍数也要知道。使用 credits 时,Fast模式按同模型标准费率的2倍计,Ultrafast按所选模型标准费率的6倍计。这两个模式是给赶时间的场景用的,日常跑量用标准模式,成本差一倍到六倍。Codex平均每位开发者每月约100到200美元,实际随模型、并发实例、自动化和快速模式变化很大,别拿这个数当API的通用成本。
钱怎么收:OpenAI只收你的钱,客户的钱要你自己收
这个项目里,OpenAI是收款方,不是付款方。它按token收你的钱,不给你提现。客户付你的钱,走你自己的收款渠道。把这两个方向分清,后面就不会问“OpenAI什么时候给我结算”这种问题,它不结算给你。
付款侧,官方条款写了几条。购买服务须提供完整准确的账单信息和有效付款方式;部分服务可以预先购买服务信用,服务信用受Service Credit Terms约束;付费订阅可以随时取消;可以设组织或项目的支出上限,控制每月API花费。这几条是你付钱给平台的规则,不是平台付钱给你的规则。
收款侧,OpenAI不涉及给开发者提现,所以官方页没有提现门槛与到账方式。接单平台、SaaS平台的结算规则以各平台官方页面为准。这块是每个平台自己的事,平台不同,结算周期和门槛都不同。
收款渠道按你所用平台的官方说明走。
接单收钱这条线,站内 /guowai-ai-jiedan-pingtai/ 列了平台方向。看平台时重点看三样:它收不收佣金、什么时候结算、出了问题找谁。这三样在平台官方页面上都有,找不到就先别注册。
坑和规则:条款里这几条会直接封号或停服
最硬的一条是地区,名单外访问或提供访问可能导致封号或暂停,上一节讲过了。其次是条款里列的一串禁止动作,这些不是建议,是封号依据。
禁止动作包括:不得修改、复制、出租、出售或分发任何服务;不得自动或程序化提取数据或输出;不得把非人类生成的输出表示为人类生成;不得干扰或破坏服务,包括规避速率限制或绕过保护措施与安全缓解措施;不得用输出开发与OpenAI竞争的模型;不得逆向工程、反编译或发现服务源码或底层组件。做应用时最容易踩的是第二条和第四条,批量抓输出、用多key绕限速,都在禁止范围内。
封号与申诉的规则在条款里。违反条款或使用政策、为遵守法律、或使用可能造成风险或伤害时,OpenAI保留暂停或终止访问、删除账号的权利。账号超过一年未使用且不是付费账号,也可能被终止,会提前通知。认为误封,可以联系支持团队申诉。申诉前先自己对照条款,看是不是碰了上面那几条。
限速坑要提前防。速率限制按组织级和项目级定义,不按用户级;随模型不同而变化。流量达到每分钟100万输入tokens后,每15分钟增幅不超过50%。请求速率增长过快会返回429和slow_down,模型临时过载会返回503和server_is_overloaded。响应头Retry-After给的是最少等待秒数。官方还写,提供程序化访问、批量处理功能和自动社交媒体发布时要谨慎,只对可信客户开放。这三类功能最容易把限速撞满,也最容易出内容问题。
内容坑在条款里写得很清楚。输出可能不总是准确,不应作为唯一事实来源或专业建议的替代。使用或分享输出前,须评估准确性和适用性,包括适当人工审核。不得把涉及个人的输出用于对其有法律或重大影响的用途,比如信贷、教育、就业、住房、保险、法律、医疗等决策。做工具卖给老外,这条要写进你的产品说明里,别让客户拿你的输出直接做人事或贷款决定。
模型本身的毛病也要知道。官方在2022年发布ChatGPT时自己写过:有时会写出听起来合理但错误或无意义的答案;对输入措辞的微调敏感,同一提示多次尝试结果可能不同;常常过于冗长并过度使用某些短语;用户查询含糊时,通常猜意图而不是追问澄清;有时会回应有害指令或表现出偏见。这些不是旧闻,是模型类产品的共性,做应用要有人工审核兜底。
责任上限这一条也来自条款。OpenAI的总责任不超过索赔前12个月为该服务支付的金额与100美元中的较高者。知道这条不是让你去索赔,是让你明白服务的责任边界在哪,别把平台的承诺当成对你客户的承诺。
条款原文整理成对照表,可以交给猎者出海的AI Agent做初稿,哪些动作会封号要自己按原文核。条款会更新,对照表也要跟着更新。
AI在这个项目里能做哪几步、人要核什么
AI能替你写请求骨架、写JSON schema、写重试函数、拆智能体步骤这四步。建key、设上限、定层级,必须你自己在后台点。这四步能省的是打字时间,不是判断时间。下面四条提示词是本文给的示例,不是官方模板,照着改再跑。
第一条,写请求骨架:“读官方Responses API的示例,用Python写一个最小可运行脚本,输入是一段用户问题,输出是模型回答文本,key从环境变量OPENAI_API_KEY读取,不要硬编码。”AI交出来的是骨架,你要自己跑通,核输出是不是你要的格式,核异常分支有没有处理。
第二条,写JSON schema:“按Structured Outputs的要求,为‘用户提交一段产品描述,返回标题、卖点三条、目标人群’设计一个JSON schema,并给出对应的请求示例代码。”AI交schema,你要核字段是不是客户能看懂、有没有漏字段、模型返回能不能解析。字段名别用模型爱猜的抽象词,用产品页上会出现的大白话。
第三条,写重试函数:“按速率限制文档里429 slow_down和503 server_is_overloaded的说明,写一个带Retry-After处理、指数退避和随机延迟的请求重试函数,并注释每种错误码对应什么动作。”AI交草稿,你要核重试会不会把一次429变成连续撞墙,退避时间够不够,随机延迟有没有加。这三点核不住,重试函数本身就是新的故障源。
第四条,拆智能体步骤:“按Agents SDK的工具、交接、审批概念,把‘收需求、调模型、人工审批、输出’拆成可编排的步骤清单,标出哪一步必须人工确认。”AI交步骤清单,你要核审批那步是不是真的拦住了输出,还是只是个标记。审批放在输出之后,等于没审。
人要做的动作有四件。一,在平台首页用OpenAI账号登录,进后台按“Get started Create API key”创建key。二,在Settings > Organization > Limits看层级限制,按需设Spend alert或Hard spend limit。三,在Usage Tiers区域决定要不要买信用升级层级。四,AI生成的代码自己跑通,输出自己核准确性,条款要求人工审核,这条不能省。
不吹全自动。AI写出来的代码会漏错误处理、会假设字段、会忘了key从环境变量读,这些都要人补。全自动在这个项目里不成立,条款就要求人工审核,产品页上也得写清楚输出需要人工确认。站内 /prompt-gongcheng-zhuan-meijin/ 讲的是Prompt工程赚美金那条线,和这里的写代码、做应用不是一回事,可以对照看边界。
常见问题
中国大陆能不能注册OpenAI API?
官方支持地区名单逐条列出,未见China、Hong Kong,官方没有就中国大陆单独表态,以官方为准。名单外访问或提供访问,可能导致账号被封禁或暂停。
判断路径是先查官方支持地区页,再看条款里的账号要求和付款要求。两条都过再谈做不做,过不了就先换方向,别先写代码。
API现在多少钱?
官方定价页只写“ChatGPT API Start creating with OpenAI's powerful models”,具体单价页没抓到。能核的是2023年公告里gpt-3.5-turbo每1k tokens 0.002美元、Whisper每分钟0.006美元,以及后来的信用费率表。
2024年4月24日官方更新说明,ChatGPT API这一名称已停用,文中提到的ChatGPT API指GPT-3.5 Turbo API。查价以官方定价页为准,别拿旧公告当现价。
用量层级怎么升?
用量层级随组织累计信用购买额达到阈值自动升级:Build门槛5美元、Launch门槛100美元、Grow门槛500美元。升级入口在Usage Tiers区域,选Upgrade tier。
达到层级门槛不等于拿到所有模型的访问权,模型访问和速率限制是分开的。Free层级每月额度100美元,要求用户处于允许的地理区域。
怎么防止调试把额度烧光?
设Hard spend limit,触发后受影响的API请求返回429。Spend alert只发通知,API流量继续,拦不住超额。两个都设,一个提醒一个兜底。
先设上限再写代码。调试期请求小但次数多,循环里忘了停,一晚上跑掉的量可能比上线第一周还多。在Settings > Organization > Limits能看当前层级的限制。
请求报429或503怎么办?
429 slow_down是请求速率增长过快,503 server_is_overloaded是模型临时过载。按响应头Retry-After等待后重试,别立刻重发。
流量到每分钟100万输入tokens后,每15分钟增幅不超过50%。重试函数要带退避和随机延迟,别把一次429变成连续撞墙。
账号被停了能申诉吗?
官方条款写,认为账号被误封,可以联系支持团队申诉。申诉前先对照条款看是不是碰了禁止动作:名单外访问、自动提取输出、把非人类输出说成人类生成、规避速率限制。
申诉时把账号、项目、时间点说清楚,别在申诉信里附API key。联系支持时不分享key这条,官方文档写得很明确。
用API做出来的东西归谁?
条款写用户保留输入的所有权,并拥有输出。你拿API做出来的应用,输出归你或你的客户,具体看你和客户的合同。
由于服务和AI的性质,输出可能不唯一,其他用户可能得到相似输出。所以别把“独一无二”当卖点写进产品页,写进去就是给自己埋投诉。
新手先做哪条路径?
官方文档列了Responses API、Agents SDK、Models三条构建路径。先按Responses API发通第一个请求,再谈智能体和多步流程。第一个请求跑通,比看十篇教程有用。
四条方向里,接单开发回款最快,SaaS工具最慢但可复用。先选一个能交付具体结果的,别一上来做万能助手。海外AI赚钱兼职的其他做法,站内 /haiwai-ai-zhuanqian-jianzhi/ 有汇总,可以对照自己适合哪条。
这个项目的门槛不在写代码,在地区合规和成本控制。API按token计费,模型选错差100倍;名单外的账号风险,官方写得很直白。先把账号和支出上限弄明白,再做第一个能跑通的最小版本,比先想商业模式实在。

发表评论