

一个模型排第几,不是跑分跑出来的,是150万条真人盲投一条一条堆出来的。FastChat仓库里写着,Chatbot Arena靠并排LLM对战收集了超过150万条人类投票,用来编在线Elo榜。你看到的排名,来自一个个真人在两个匿名模型之间点的那一下。
LMArena就是Chatbot Arena,LMSYS Org做的众包匿名对战大模型基准平台,项目页上它的状态标着Graduated。国内能不能注册,以官方为准;费用这块官方页面上留的是Sponsor Us和Donations两个入口。这篇先把哪部分是平台、哪部分是开源代码分清楚,再讲怎么用。
几个能直接拿来判断的数字:
- 150万+条人类投票,来自并排LLM对战,用来编在线Elo榜
- 本地跑Vicuna-7B单卡约14GB显存,13B约28GB;纯CPU是30GB和60GB内存
- FastChat代码Apache-2.0许可,装完能起web UI和OpenAI兼容API
- 仓库当前905个open issues、143个open pull requests,其中一个open issue指出UI有跨站脚本漏洞
- FastChat给70+个LLM服务过超过1000万次对话请求
| 项目 | 结论 |
|---|---|
| 谁家的 | LMSYS Org的Chatbot Arena,项目页标注Graduated |
| 国内能否注册 | 以官方为准 |
| 费用与抽成 | 官方页未写,页面留Sponsor Us与Donations入口 |
| 收付款方式 | 官方页未写 |
| 适合谁 | 要选模型、要比模型、要自己搭对战界面的人 |
能确认的硬信息就它的出身和那套开源代码,价格、账号这类事只认官方页面当期显示的东西。
本文目录
LMArena是什么:LMSYS的众包盲投榜单,不是跑分网站
LMArena这个名字常和「大模型排行榜」绑在一起,但它的做法跟跑分网站不是一回事。跑分网站拿一套固定题库测一遍,出一组分数;它把两个模型匿名摆在一起,让人读完两段回答选更好的那个,投票累积成Elo排名。名次来自人的偏好,不来自题目的标准答案。
背后是谁:LMSYS Org和Chatbot Arena
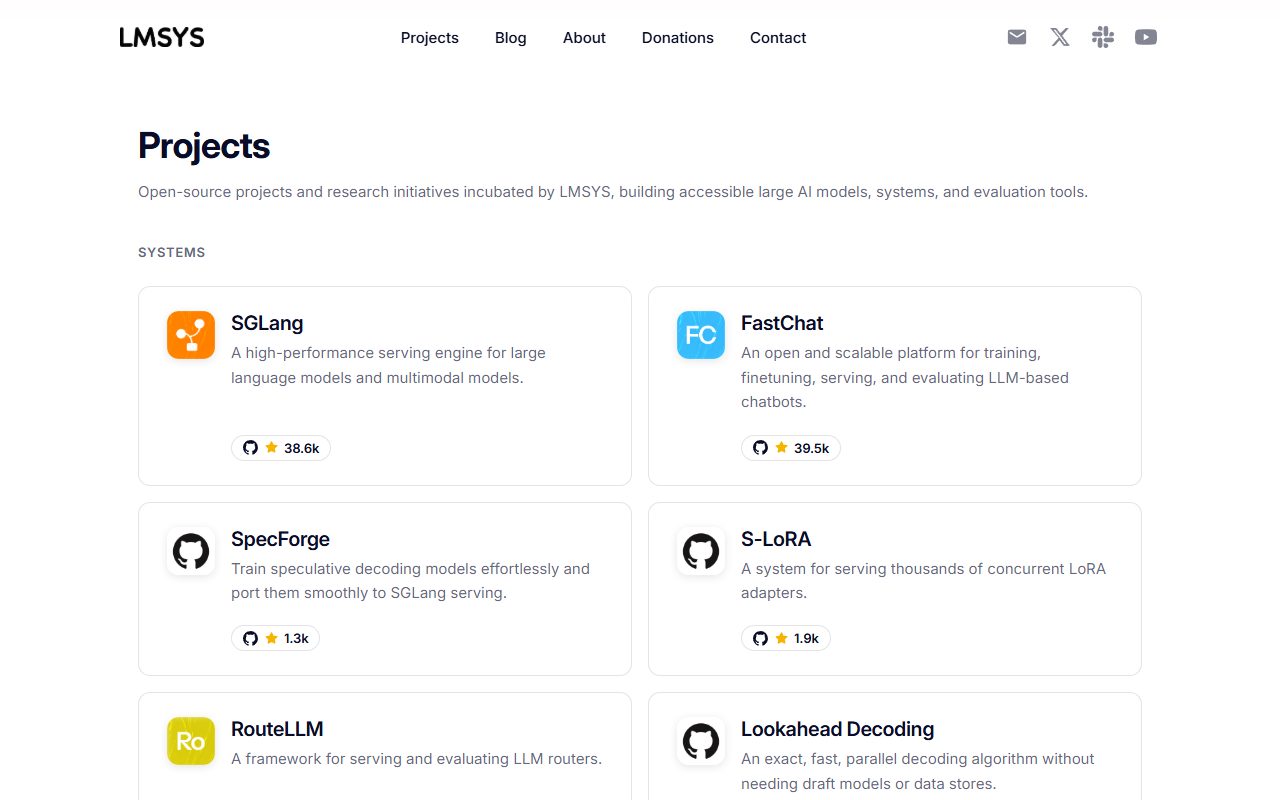
LMSYS Org的全称是Large Model Systems Organization,官网写的是开发开放、可访问、可扩展的大模型与系统。官网首页列的数字是15+个项目、89K+ GitHub Stars、1000+ Contributors。
Chatbot Arena是它下面的评测类项目,项目页上的状态写着Graduated,定位是以众包方式做匿名随机对战的LLM基准平台。匿名、随机、众包这三个词不是包装词,就是它的做法本身。同一个项目页上还有Arena Hard Auto和MT-Bench,评测是LMSYS的一条主线,不是顺手做的一个页面。
榜单怎么来的:FastChat撑着,投票编Elo
FastChat是Chatbot Arena背后的平台。仓库主页写着它给70+个LLM服务了超过1000万次对话请求,Chatbot Arena靠并排对战收了150万+条人类投票,用来编在线Elo榜。这三个数是一条链:有人来对战,才有投票;投票够多,榜才有参考价值。
FastChat自己的定位是训练、服务、评测大语言模型的开源平台,也是Vicuna和Chatbot Arena的发布仓库。仓库现在是39.5k stars、4.8k forks、890 commits,许可用Apache-2.0。你要复刻它的对战界面,靠的就是这个仓库,不是LMArena那个榜单页面。
对战里能出现哪些模型
FastChat支持的开源模型清单里有LLama 2、Vicuna、Alpaca、Baize、ChatGLM、Dolly、Falcon、FastChat-T5、GPT4ALL、Guanaco、OpenAssistant、OpenChat、RedPajama、StableLM、WizardLM、xDAN-AI等。闭源的也能进,靠api_endpoint.json把API端点写进去,OpenAI、Anthropic、Gemini、Mistral都在这套配置的支持范围里。
要拿ChatGPT、Gemini这类闭源模型来比,走的就是API端点这条路。它们各自的情况站内分别写过,可以接着看ChatGPT测评和Gemini测评。
LMArena能做什么:看榜、投票、自己搭对战界面
把它拆成四件具体的活,你按自己要干的事对上去看。
想选模型:看匿名随机对战和Elo榜
最直接的用法是看榜。两个模型匿名出现,你读完两段回答选一个更好的,票就这么投出去,累计成Elo。榜上不挂名字的时候,你判断的是回答本身,不是牌子和参数。对一个要挑模型干活的人来说,这个信号比一张跑分表更接近真实使用场景。
想自己出题比模型:MT-bench的思路
FastChat做评测用的是MT-bench,一组有挑战性的多轮开放式问题。这套思路你自己能搬:先定10个左右的多轮问题,覆盖写作、推理、代码三类,两个模型各答一遍,你按偏好记录,最后看谁在你关心的那类问题上更稳。
裁判这一段要留个心眼。强LLM当裁判能省下大量时间,但它的偏好会进结果,题目和评分标准要先写死,别边看边改。
想在自己机器上复刻一个对战界面
FastChat的核心功能之一是一个分布式多模型服务系统,带web UI和OpenAI兼容的RESTful API。多模型的意思是可以把多个model worker注册到同一个controller,用于单模型高吞吐,也可以同时服务多个模型。想拿它当本地替代,官方写明FastChat提供OpenAI兼容API,可以作为OpenAI API的本地替代。
想拿真实对话数据做研究
LMSYS放出来的数据集里有三个能用的。LMSYS-Chat-1M是100万条真实对话,覆盖25个SOTA LLM;Chatbot Arena Conversations是33K条清洗过、带成对人类偏好的对话;ToxicChat是10K条内容审核数据。要研究人在两个回答之间怎么选,第二个数据集的字段直接对口,省掉自己攒数据的几个月。
LMArena怎么用:从看榜到本地跑起对战界面,六步
分两条路。想自己搭一个对战界面,往下走FastChat的六步。
第一步:先决定你要看榜还是自己搭
自己搭要有机器、有模型、有一点命令行基础,还要先想清楚是跑本地权重还是接外部API,这两条准备的东西完全不同。先定下来,再往下看。
第二步:装FastChat,两条命令选一条
第一种是从pip直接装:
pip3 install "fschat[model_worker,webui]"
第二种是从源码装,先克隆仓库,再以可编辑模式安装:
pip3 install -e ".[model_worker,webui]"
两条选一条就行,装的是model worker和webui这两个组件。起服务的时候是三个组件配合:面向用户的web server、承载模型的model worker、协调两者的controller。
第三步:起controller
python3 -m fastchat.serve.controller
它在中间做协调,不加载模型。这一步没起来,后面两步连不上,报错还会指向奇怪的地方。先起它,再动别的。
第四步:起model worker,把模型路径给对
python3 -m fastchat.serve.model_worker --model-path lmsys/vicuna-7b-v1.5
--model-path可以是本地文件夹,也可以是Hugging Face仓库名。写仓库名的话第一次会把权重下载下来,存在用户主目录的.cache文件夹里,路径大概是~/.cache/huggingface/hub/<model_name>。机器上已经有模型文件,直接写本地路径,省掉一次下载。
第五步:起Gradio web server,发一条测试消息
python3 -m fastchat.serve.gradio_web_server
起来之后浏览器里能打开页面。worker有没有真连上controller,用这条测:
python3 -m fastchat.serve.test_message --model-name vicuna-7b-v1.5
页面里模型不显示,按文档说的重启gradio web server。
第六步:接自己的模型服务,写api_endpoint.json
要比对的是外部API上的模型,不走本地权重,就在工作目录建一个api_endpoint.json,把要服务的模型端点写进去,然后这样起:
python3 -m fastchat.serve.gradio_web_server_multi --register-api-endpoint-file api_endpoint.json
几种api_type的写法不一样。Anthropic的模型写"api_type": "anthropic_message",配你自己的Anthropic key;Gemini写"api_type": "gemini"。
LMArena收费:能确认的只有这些
这一块能确认的东西不多,但每一条都是硬的,照下面这张表看就行。
| 项目 | 结论 |
|---|---|
| 平台使用费 | 官方页未写,页面留Sponsor Us与Donations入口 |
| 订阅档位 | 官方页未写 |
| 抽成 | 官方页未写 |
| 代码许可 | FastChat用Apache-2.0 |
代码那一层是完全开放的,钱的那一层官方页面上没写,别处看到的数字都只能当参考。
官网首页的赞助方名单里能看到NVIDIA、Google Cloud、AMD、a16z、Kaggle、MBZUAI、Together、RunPod、Anyscale、HuggingFace等,另有一个Sponsor Us入口和一个Donations入口。赞助和捐赠是两条不同的路,都跟你能不能用得上没关系,看的时候分开看。
你自己要做的就两件事:用之前打开官方页看当期说明;自己部署的部分只认Apache-2.0这个许可。FastChat是Apache-2.0,拉下来跑不产生授权费,但Vicuna这类模型是另一层许可,下面测评一节会写。把这两层混在一起算成本,最后一定算错。
LMArena测评:三件能落到实处的事和三个要提前看清的坑
优点和坑都摆在明面上,按能不能帮你干活来判,不打分。
优点:三件能落到实处的事
先说最要紧的,榜单来自人。150万+条投票是真人对着两段回答点出来的,不是一套题库跑出来的分数。你要判断某个模型在真实提问下的表现,这个来源比你自己的主观感受多了一层样本。
还有个事,代码在你手里。FastChat是Apache-2.0,39.5k stars说明有一堆人在盯着它改。它的web UI和OpenAI兼容API让你能在自己机器上复刻一套对战界面,也能把它当成OpenAI接口的本地替代。
对了,起点成本可以压得很低。官方的REST API能在Google Colab免费层跑,仓库里有对应的notebook。想先看看这套东西跑起来是什么样,不用先买卡。
缺点和坑:显存、速度、维护状态
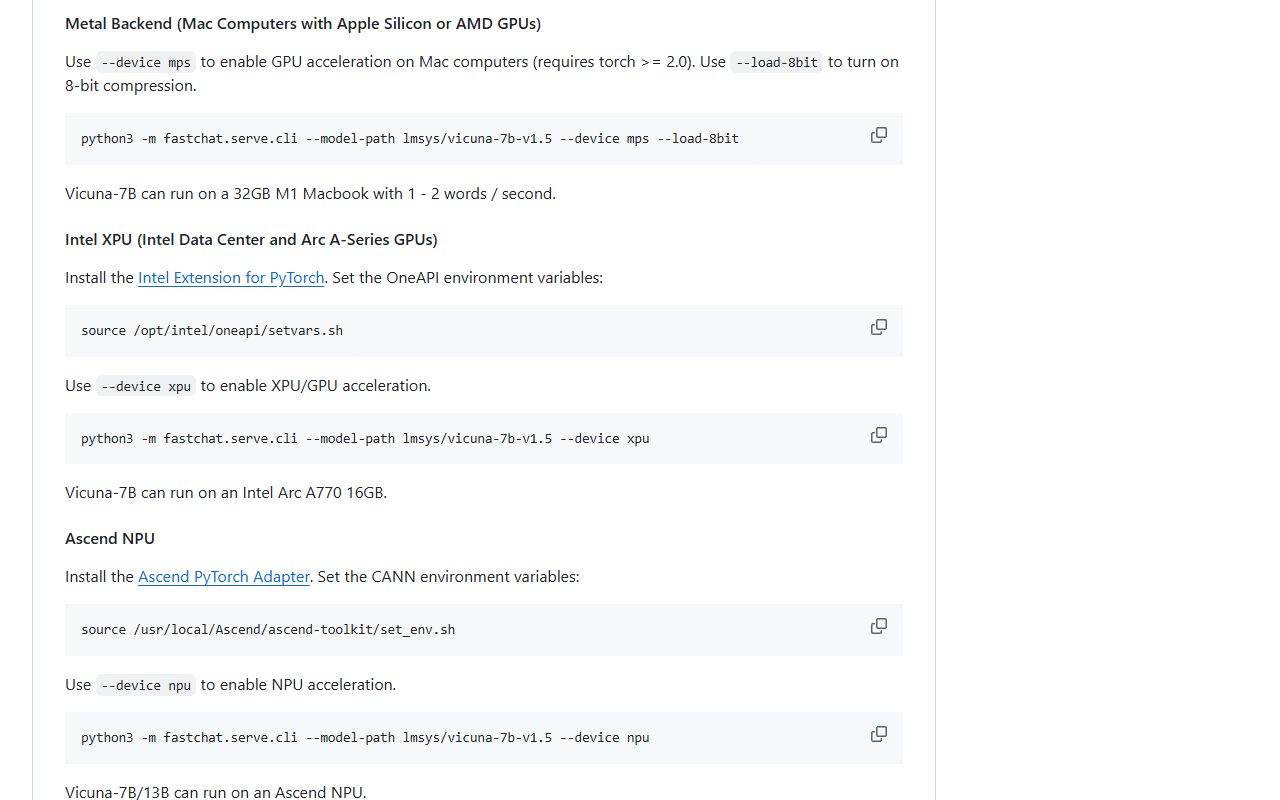
最硬的门槛是显存。单GPU跑Vicuna-7B大约要14GB显存,13B大约要28GB;纯CPU的话,7B要30GB内存,13B要60GB。手上是32GB的M1 Macbook,7B能跑,速度是每秒1到2个词,拿来试流程可以,拿来天天干活会等得难受。想省一点,Vicuna-7B还能跑在Intel Arc A770 16GB上。
显存不够有两条路。加--load-8bit开8-bit压缩,内存占用降大约一半,代价是模型质量略有下降;13B压完能上16GB单卡,比如RTX 3090、RTX 4080、T4、V100 16GB或AMD RX 6800 XT。另一条是--cpu-offloading,但它要求先开8-bit压缩、装bitsandbytes,而这个包只在Linux上能用,Windows上这条路走不通。
速度这块还有两个细节。默认基于huggingface/transformers的model worker兼容性好,但可能慢;要高吞吐批量服务,可以上vLLM集成。多卡机器上,transformers的auto设备映射有时没法把显存在多张卡之间分匀,看到显存一边满一边空,先想到这一点。
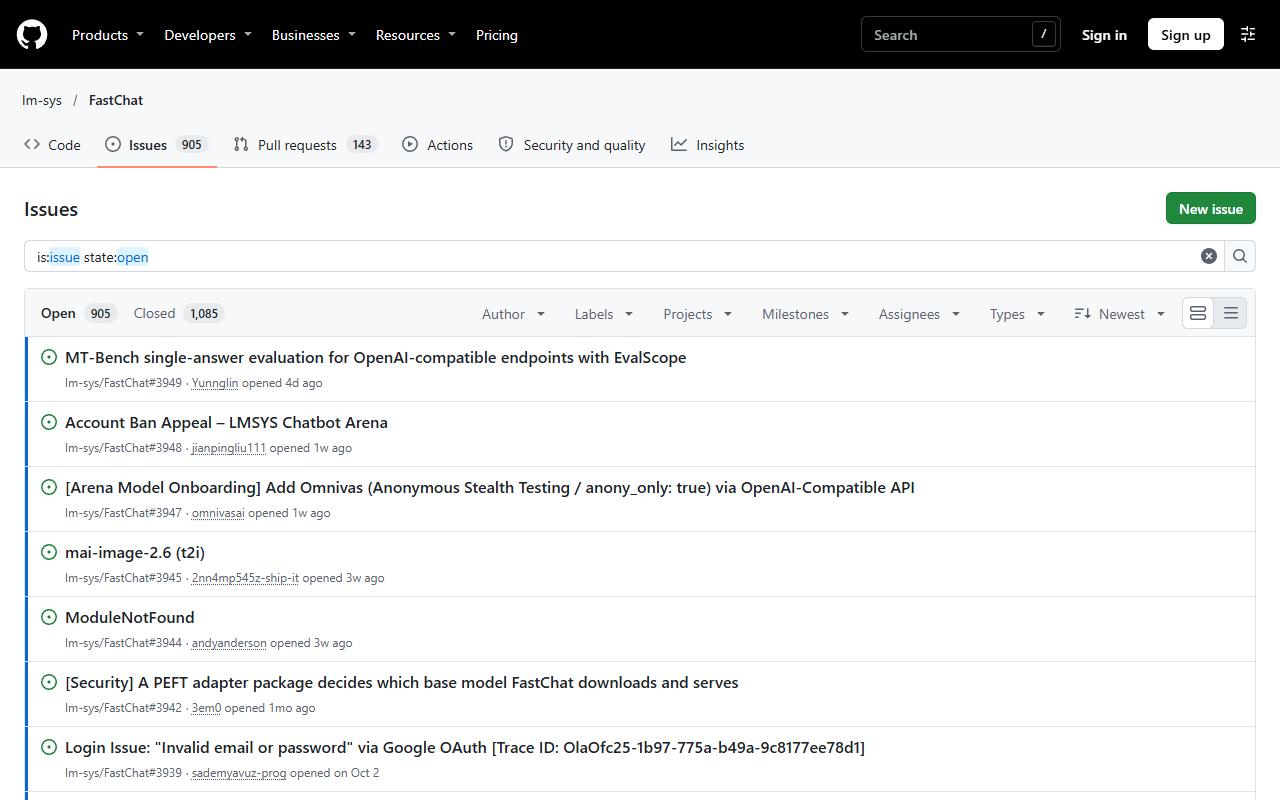
维护状态要看清。仓库当前905个open issues、143个open pull requests,其中有一个open issue指出UI存在跨站脚本(XSS)漏洞。自己部署给内部用是一回事,挂到公网上给别人用是另一回事,这个漏洞在修好之前得你自己评估风险。
还有一层许可。Vicuna基于Llama 2,要按Llama的模型许可使用,这跟FastChat的Apache-2.0不是同一个东西。要把模型用进商业项目,这两层分开看清楚再动手。
适合谁用,谁别从这条路进
要选模型的人适合。你不确定两个模型哪个更合你的活,上去对几轮,看投票结果和榜单,比自己拍脑袋强。
要比模型的人适合。手上有明确的业务问题,想按MT-bench那套思路自己出题,FastChat的评测代码和强LLM裁判能直接拿来用。
要自己搭对战界面的人适合。Apache-2.0、有web UI、有OpenAI兼容API,这三样凑在一起的东西不多。
只想找个人聊天、不想碰命令行的,别从这条路进。装环境、起三个服务、调显存,每一步都要动手,这些时间花在现成助手上更值。
替代品:不想自己搭,还有别的入口
FastChat官方的说法是它提供OpenAI兼容API,可以当作OpenAI API的本地替代。这句话的重点在「本地」两个字:模型、数据、调用方式都在你手上,代价是环境要自己装、速度要自己扛。
如果你的活是查资料、找答案,或者想不写代码把一套流程搭起来,站内这两篇可以对照着看:Perplexity实测和扣子Coze测评。三个东西解决的不是同一个问题,先想清楚你要的是本地可控,还是开箱能用,别为了一个功能装一整套环境。
本地部署的中文模型来源:官方给了这一条路
FastChat的文档里有一句是写给中文用户的:中文用户可以通过设置环境变量使用modelscope.cn上的模型,写法是export FASTCHAT_USE_MODELSCOPE=True。环境变量设上,模型从modelscope.cn拉,这条路在自己机器上部署是走得通的,不用去别处找模型镜像。
平台侧的注册和地区要求,按官方注册页当期显示的来。你要在国内判断国产模型现在到什么水平,站内两篇写得比较细:DeepSeek测评和千问AI助手测评。
这里要把两件事分开:一件是上lmarena.ai看榜投票,一件是把FastChat拉到自己机器上跑。后一件有中文用户的环境变量支持,前一件按官方页面的要求办,别把两件事的条件混着用。
用AI配合LMArena:把命令、配置和题单交给它整理
这套东西的麻烦不在原理,在细节:三条启动命令的先后顺序、api_endpoint.json的键名、显存够不够跑。这些恰好是AI能替你理清的部分,动手的还是你。
能帮上的有四步。一是把FastChat文档里的安装与启动命令读成一份操作清单,标出controller、model worker、gradio web server各自的职责和先后。二是把api_endpoint.json的字段结构(model_name、api_base、api_type、api_key、anony_only)解释清楚,对着你自己的模型服务往里填。三是把MT-bench的思路转成你自己选模型时用的对比问题清单。四是把文档里的显存和内存要求换算成「我这台机器能不能跑」的判断。
下面三条提示词是本文给的示例,不是官方模板,照抄之后改成你自己的情况再用。
- 「我在本地按FastChat文档启动Chatbot Arena对战界面,已经写好api_endpoint.json。请按controller、model worker、gradio web server的顺序,列出每一步要检查什么,出错时先看哪一行日志。」
- 「我的机器是16GB显存的单卡,想跑Vicuna-13B。请根据FastChat文档里8-bit压缩的要求,告诉我需要加哪些参数、哪些系统上不能用cpu-offloading。」
- 「我要用MT-bench的思路对比两个模型。请帮我设计10个多轮开放式问题,覆盖写作、推理、代码三类,并说明怎么记录偏好判断。」
必须你自己动手的是三个动作:在自己的终端里按顺序执行controller、model worker、gradio web server三条命令,确认model worker已经注册到controller;打开api_endpoint.json,按你要用的模型服务填上api_base、api_type、api_key三个字段;在浏览器里打开本地页面,实际发一条消息,看模型回不回。这三步AI替不了,它只能在你卡住的时候告诉你去看哪一行。
整理文档、对照官方条款这类活,可以交给猎者出海的AI Agent,它装在你自己的电脑上,把这堆资料收拢成一份能照着做的清单,省掉来回翻文档的时间。
常见问题
LMArena是什么?
LMSYS Org的Chatbot Arena,一个众包匿名随机对战的大模型基准平台,项目页状态标着Graduated。名次来自并排对战收集的人类投票,编成在线Elo榜,不是一套题库跑出来的分数。
LMArena收费吗,能免费用吗?
官方页面上是Sponsor Us与Donations两个入口,价格按当期页面显示的来。FastChat代码是Apache-2.0许可,自己部署不产生授权费,模型本身的许可另算,两笔账别混在一起。
LMArena怎么用?
两条路。自己搭就装FastChat,先起controller,再起model worker,最后起gradio web server,三条命令和api_endpoint.json的写法在前面第三节都给了。
LMArena和FastChat是什么关系?
FastChat是Chatbot Arena背后的平台,给70+个LLM服务过1000万+次对话请求,也是Vicuna和Chatbot Arena的发布仓库。你要复刻的对战界面就是它,榜单页和仓库不是同一个东西。
跑Vicuna要什么配置?
7B单卡约14GB显存,13B约28GB;纯CPU是30GB和60GB内存。13B开8-bit压缩能上16GB单卡。7B在32GB的M1 Macbook上能跑,速度每秒1到2个词。双卡机器还要注意auto设备映射分不匀显存的情况。
内存不够怎么办?
在命令里加--load-8bit开8-bit压缩,内存占用降大约一半,代价是质量略有下降。想再省可以上--cpu-offloading,但要先开8-bit压缩、装bitsandbytes,而这个包只在Linux上能用,Windows上这条走不通。
模型不显示怎么办?
先重启gradio web server,这是文档里给的第一个动作。还不确定model worker有没有连上controller,用test_message命令测一遍。启动顺序记牢:controller在前,model worker在中,web server在后。
国内能不能用?
FastChat文档写明中文用户可以通过设置FASTCHAT_USE_MODELSCOPE=True使用modelscope.cn上的模型,本地部署这条路有官方写法。平台侧的注册和地区要求按官方页面当期显示的来。
说到底,LMArena这类工具的价值不在多一个榜,而在它把「哪个模型更好」这件事交回给用的人。你要选模型,它给你150万+条人投出来的数据;你要自己比,它给你一套Apache-2.0的代码,能把对战界面搬到自己的机器上。两条路选哪条,看你是想省时间,还是想把过程握在手里。

发表评论