

别的模型是把思考藏起来,DeepSeek这套深度思考模式反过来,默认就开着,effort默认还停在high这一档,你要做的是学会什么时候把它关掉。官方文档给它的定义只有一句:模型在输出最终答案前,先输出一段思维链推理,用来提高最终回答的准确性。
深度思考指的就是这套思考模式。网页版、App、API三个入口都会碰到它,页脚写的版权方是杭州深度求索人工智能基础技术研究有限公司。网页版和App的收费以官方为准;要提前把成本算清楚,走API,价格按每百万tokens列。
- 思考模式默认开启,effort默认high;不设max_tokens时思考模式默认64K,非思考模式8K。
- deepseek-flash输出每百万tokens空闲$0.6、高峰$1.2,中文口径写空闲4元、高峰8元。
- deepseek-v4-pro输出每百万tokens空闲$1.98、高峰$3.96,中文口径写空闲13.5元、高峰27元。
- Search与Fetch每1,000次成功请求$0.75,中文口径写5元。
- 高峰时段是北京时间周一至周五9:00-12:00、14:00-18:00,空闲价是高峰的一半。
| 项目 | 结论 |
|---|---|
| 谁家的 | 杭州深度求索人工智能基础技术研究有限公司 |
| 国内能否注册 | 以官方为准 |
| 费用 | API 按 token 计费,deepseek-flash 输出每百万 tokens 高峰 8 元、空闲 4 元 |
| 收付款方式 | 费用从充值余额或赠送余额扣减,支付渠道按官方充值页面的选项走 |
| 适合谁 | 需要先出思维链再给答案、回答前要调用工具的任务 |
表里唯一要你自己去确认的是注册那一格,别的几行文档里都能对上号。
本文目录
深度思考 DeepSeek 是什么,和普通对话差在哪
把思考模式当成一个开关,容易误会。它是模型回答前的一道工序:先写推理,再给结论。这段推理单独返回,不跟正文混在一起,你拿到的是两段内容。
官方怎么定义思考模式
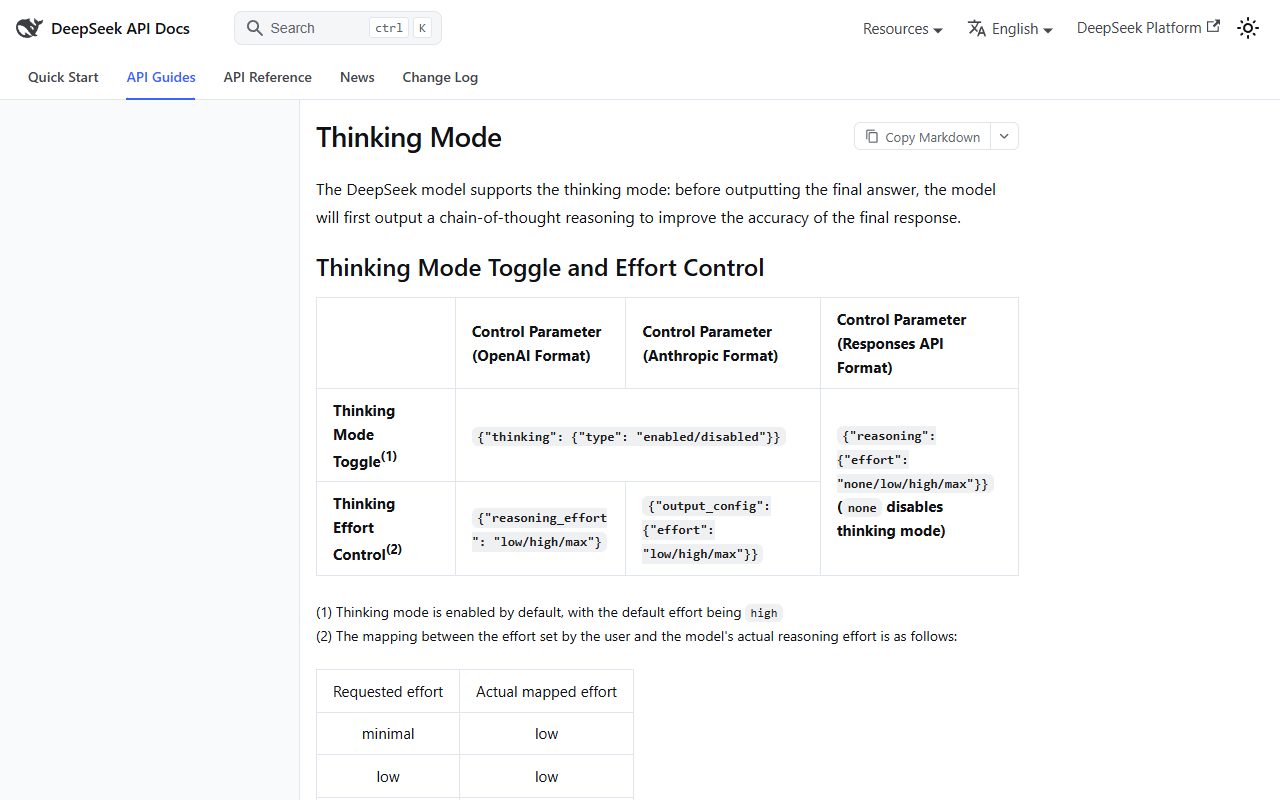
接口文档写明思考模式在输出最终答案前先输出一段思维链推理,用来提高最终回答的准确性,同一页写明思考模式默认开启,默认effort为high。你不去动它,每个请求都是带推理的。
effort有三档:low、high、max。另外留了一套兼容写法,传进来的值会被映射,minimal和low算low,medium、high、xhigh算high,max和ultra算max。effort就是你告诉模型用多大力气推理,默认停在high。
它和普通模式差在哪
最直观的一处是返回结构。思考模式下,思维链走reasoning_content这个字段回来,和content同级,要不要展示给前端用户由你定。普通模式只有content,一段正文。
还有三个在别处很好使的参数,到思考模式里直接失效:temperature、presence_penalty、frequency_penalty。设置了不报错,也不生效,这是为了兼容已经接好的代码。你如果靠temperature调输出风格,这个活在这套模式下干不成。
长度上也有差别。max_tokens不设的话,思考模式默认64K,非思考模式默认8K,effort设成max时是128K。上限是384K,要写长东西,得在请求里显式给max_tokens。
top_p的行为跟着模型走。deepseek-flash在思考模式下默认1.0,低于0.95的值按0.95处理;非思考模式固定1.0,传进去的值被忽略。deepseek-v4-pro在思考模式下开了工具调用就固定0.95,否则1.0,传进去的值同样被忽略。
还有一条容易漏:FIM补全(Beta)只有非思考模式支持。要用补全能力,先把思考关掉。
版本与模型
官网研究栏列出的模型有V4.1、V4、V3.2、V3.1、R1、V3。首页写着DeepSeek V4.1 Flash已更新到V4.1-Flash-1017版本,新增API支持网页搜索与抓取。
实际调用时能填的模型名是两个:deepseek-flash和deepseek-v4-pro,这两个都支持非思考与思考(默认)模式。API的格式跟OpenAI、Anthropic兼容,改一下配置就能用对应的SDK访问。
想先弄清整个模型家族和各版本的关系,站内有一篇DeepSeek AI大模型可以对着看。国外同类的工具怎么挑,另一篇国外AI工具里有横向的取舍思路。
DeepSeek 怎么开启深度思考:网页、App 和 API 三条路
答案分两半:网页和App上是找入口,API上是设参数。默认值已经开好了,多数时候要确认的是有没有被关掉。
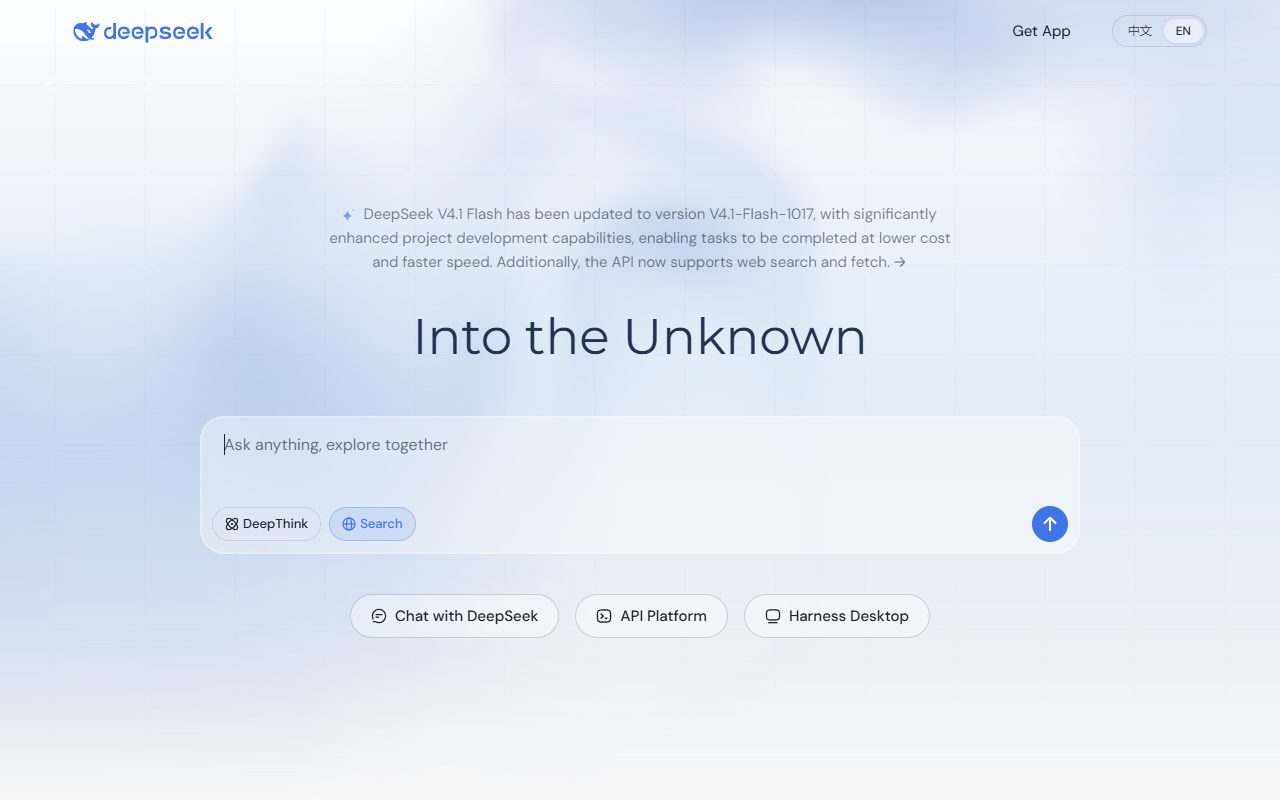
网页版和 App
官网首页的导航里,「深度思考」「智能搜索」「和 DeepSeek 对话」「API 开放平台」「Harness」「桌面端」是并列的几个入口。
首页的产品栏里还列着DeepSeek应用下载、DeepSeek网页版、DeepSeek Harness、API开放平台、API文档、API价格、服务状态。要装桌面端,走应用下载那个入口,站内有一篇DeepSeek电脑版下载安装写得比较细。
网页版和App的用法很轻,打开就能问,不用管参数。跑不通的时候先去看服务状态那一页,能先排除掉一半自己代码的问题。
API 三步
接口文档给的路子只有三步:先申请一个API key;再在终端里把环境变量DEEPSEEK_API_KEY设成你的key;然后拿OpenAI格式的base_url https://api.deepseek.com 去调对话接口,模型名填deepseek-flash或deepseek-v4-pro。
两个模型的规格是:都支持非思考与思考(默认)模式,上下文长度1M,最大输出384K。用OpenAI的SDK设thinking参数时,要把它放在extra_body里传。
参数怎么设
thinking是个对象,写成 {"thinking": {"type": "enabled/disabled"}},enabled是开,disabled是关。reasoning_effort是另一个字段,取low、high、max,取none就是关掉思考。
两个字段有先后关系。thinking省略或者传null时,模式跟着reasoning_effort走;reasoning_effort也省略,思考模式就开着。所以请求体里什么都不写,等于开着跑high。简单任务想省一点,把reasoning_effort写成none,或者把thinking的type写成disabled。
写代码的时候,把这两个字段收在一处统一处理,改起来只动一个地方。一个请求里又设thinking又按非思考的逻辑写别的参数,出了问题排查会绕远路。
深度思考和联网搜索有什么区别,什么时候该开哪个
官网首页把「深度思考」和「智能搜索」并列成两个入口,名字不一样,指的不是同一件事。思考模式管的是推理过程,模型在给答案前先把步骤写出来。搜索走的是另一套接口,Search和Fetch,两个都是只读的,拿的是网页上的现成信息。
Search和Fetch按成功请求计费,Search每个账号的QPS限制是100,Fetch是25,超出限制的请求返回HTTP 429。Fetch除了账号级限制,还有每个域名的QPS限制,另外它受目标站点可用性和访问策略的约束,被安全策略拒绝时返回HTTP 403。
思考模式支持工具调用,模型可以在输出最终答案前做多轮推理和工具调用。所以这两样不是二选一:要模型自己拆步骤、给依据的活,开思考;要把几个具体网页的内容拉进来,用Search和Fetch。
落到动作上分三种。读一篇长文档、判一段逻辑站不站得住、写一份要把理由讲清的东西,走思考。查某个站现在挂的什么价、某条规则的原文怎么写的,走搜索接口。两样都要,就开着思考再给它工具,让它自己调。
还有一点要提前知道:搜索接口的失败率不完全由你控制。目标站点打不开、访问策略拒绝,返回的是403,这种错重试也没用,换页面才是正路。429是限流,等一会儿再打。
深度思考 DeepSeek 收费吗:API 价格和余额扣费
能提前算清的钱在API这一侧。计费单位是每百万tokens,按输入和输出的总token数算,分空闲和高峰两档,空闲时段的价格是高峰的一半。
| 模型 | 计费项(每百万 tokens) | 空闲时段 | 高峰时段 |
|---|---|---|---|
| deepseek-flash | 输入,缓存命中 | $0.003 | $0.006 |
| deepseek-flash | 输入,缓存未命中 | $0.15 | $0.3 |
| deepseek-flash | 输出 | $0.6(4 元) | $1.2(8 元) |
| deepseek-v4-pro | 输入,缓存命中 | $0.022 | $0.044 |
| deepseek-v4-pro | 输入,缓存未命中 | $0.66 | $1.32 |
| deepseek-v4-pro | 输出 | $1.98(13.5 元) | $3.96(27 元) |
同一段活放在空闲时段跑,单价按官方写的是高峰的一半,钱就是这样省出来的。输出比输入贵,写长东西之前先想清楚要多少字,比事后压缩省钱。
括号里的人民币数字来自中文版价格页,和美元是同一张表的两套口径。Search和Fetch不算token,按成功请求计费,每1,000次成功请求5元,美元口径写的是$0.75。
高峰时段按北京时间算,是周一至周五(不含中国法定节假日)的9:00-12:00和14:00-18:00,其余时间按空闲价。同一段时间在英文口径里写作UTC周一至周五01:00-04:00和06:00-10:00。
扣费顺序也写清楚了:模型调用费用等于token消耗量乘模型单价,费用直接从充值余额或者赠送余额里扣,两个都有的时候先扣赠送的那份,用完了才动充值的钱。余额不足返回HTTP 402,充值之后再重试。
充值的建议是按实际用量来,价格页隔一段时间看一眼,因为产品价格可能发生变动,DeepSeek保留修改价格的权利。要开户和充值,步骤在DeepSeek API key申请与价格这篇里。
带tools的请求还有一笔隐形开销。前几轮的reasoning_content要完整回传,回传的内容会拼进上下文,轮次越多,输入越长,输入的token就越多。缓存命中那一档单价低,缓存未命中那一档高,同一套提示词反复调,两种情况的账不一样。
深度思考 DeepSeek 测评:优点、坑和适合谁用
这套思考模式的默认值给得大方,坑集中在工具调用和参数这两块。判断它值不值得用,看这两块你能不能接受。
默认值给得大方,接上就能跑
不用配置这一条最实在。思考模式默认开启,effort默认high,接上就能用,不需要在代码里额外写一行去打开它。很多能力的默认值是关的,得翻文档才知道怎么开,这里反过来,你要做的是学会什么时候把它关掉。
思考模式支持工具调用,模型可以在给最终答案前做多轮推理和工具调用,这条决定了它能干的活不止一问一答。effort有三档可调,简单的活关掉思考,复杂的留在high或max,成本和效果能分开管。价格上还有空闲时段,同一段活放到空闲时段跑,单价是高峰的一半。
四个会卡住的地方
带tools参数的请求有一个硬规定:所有前几轮的reasoning_content必须完整回传给API,漏一段就返回400。不带tools的请求反过来,reasoning_content不用回传,传了也会被忽略,不拼进上下文。这两条方向相反,代码里最好分开处理。
思考模式下,required和指定某个工具的tool_choice不支持,用了直接返回400,要先把思考关掉才能用。这是两套开关,别在同一个请求里又开思考又指定工具,报错信息只告诉你400,不告诉你是哪一行。
temperature、presence_penalty、frequency_penalty三个参数在思考模式里设了不报错,也不生效。这一条不闹错,只在结果不对的时候让人找半天。JSON Output还有一处:模型输出没法识别成JSON时,API会把非JSON的内容替换成空格,消息内容可能只剩空格,看着像模型没回话。
限流和报错也要提前知道。并发限制deepseek-flash是2500,deepseek-v4-pro是500。Search和Fetch超出账号QPS返回429,Fetch被安全策略拒返回403。遇到408、429或5xx等一会儿重试,其他4xx在没改请求之前别重试,重试只是把同一个错再撞一遍。
什么样的活交给它,什么活别在上面耗
适合需要先出思维链再给答案的活:判断一段逻辑站不站得住、把一道题拆成几步、写方案前先把依据列清楚、回答前需要调用工具的任务、要写长东西的任务。
三种情况别硬上。要用FIM补全,这个能力只有非思考模式支持。要图像理解,deepseek-v4-pro不支持,deepseek-flash支持。要靠temperature精细控制输出风格,这套模式下这个参数没有作用。
第三种情况最常见的补救办法不是换模型,是把提示词写清楚。提示词写得糙,靠温度调也调不回来,站内有一篇提示词五段式模板可以照着改,把角色、任务、约束、输出格式、示例这五段补齐,思考模式跑出来的东西会稳定很多。
用 AI 配合深度思考 DeepSeek 干活:判断开不开、写参数、排报错
API这条路要动手的地方不多,但四处容易卡。AI在这四步里能替你省掉翻文档的时间,判断还是你自己下。
- 判断一个任务要不要开思考。模型默认开着,简单任务可以关掉省token。
- 把你的需求翻成参数:thinking的type写enabled还是disabled,reasoning_effort取low、high还是max。
- 排400。带tools的请求是不是漏回了reasoning_content,是不是在思考模式下用了required或指定工具的tool_choice。
- 估token。官方口径是1个中文字符约0.6 token,1个英文字符约0.3 token。
下面三条提示词是本文给的示例,不是官方模板,可以直接复制去用。
- 「请先列出这道题的推理步骤,再给最终答案,最后用一句话说明你的结论依据。」
- 「把下面这段需求拆成 3 个可验证的子问题,逐个推理后再汇总成一段结论。」
- 「请对比 A 和 B 两个方案,先分别推理各自的前提和风险,再给出你推荐哪一个以及理由。」
有三件事只能你自己在终端和代码里做:在终端把环境变量DEEPSEEK_API_KEY设成你的API key;在请求体里按需设thinking的type和reasoning_effort的取值;请求带tools参数时,把每轮返回的reasoning_content完整回传。
官方文档里那些条款翻起来费时间,把思考模式的开关、effort档位和报错条件整理成一张对照表,这种活可以交给猎者出海的AI Agent。
常见问题
深度思考 DeepSeek 是什么意思?
模型在给最终答案前,先输出一段思维链推理,用来提高回答的准确性。这个模式默认开启,默认effort是high。
deepseek 怎么开启深度思考?
API这一侧默认就是开的,要显式写就设thinking的type为enabled,或者把reasoning_effort设成low、high、max中的一档。
deepseek 深度思考免费吗?
按API价格表,deepseek-flash输出每百万tokens空闲4元、高峰8元;deepseek-v4-pro输出空闲13.5元、高峰27元。网页版和App的收费以官方为准。账户里同时有充值和赠送两种余额时,扣费先扣赠送的那份。
深度思考和普通模式有什么区别?
返回结构上,思维链走reasoning_content,和content同级;temperature、presence_penalty、frequency_penalty三个参数在思考模式里不生效;max_tokens不设时,思考模式默认64K,非思考模式8K;FIM补全只有非思考模式支持。
deepseek-v3.2 支持深度思考吗?
官网研究栏里列了V3.2这个模型。实际调用时能填的模型名是deepseek-flash和deepseek-v4-pro,定价页写着这两个都支持非思考与思考(默认)模式。具体用哪个版本,按官方文档当时的写法填。
怎么关闭深度思考?
两个写法都行:thinking的type写disabled,或者reasoning_effort取none。
开了深度思考为什么报 400?
两种可能。请求带了tools参数,前面几轮的reasoning_content没完整回传;或者用了required和指定工具的tool_choice,这两个在思考模式下不支持,要先把思考关掉。
要用得顺,记住三件事就够了:它默认开着,effort停在high;带工具的请求必须把reasoning_content完整带回去;要控成本,挑空闲时段。工具不替你想清楚要做什么,提示词写得含糊,思考模式也只是把含糊的推理写长一点。

发表评论