
Crawl Budget这个事,最反直觉的一点是:Google从来没给哪个站设过一个叫抓取预算的额度,你在后台也找不到一个能调的数字。它指的是Google分给一个站点的抓取时间和抓取资源,由crawl capacity limit和crawl demand两个要素共同决定。Google自己的定义是「Google defines a site's crawl budget as the set of URLs that Google can and wants to crawl.」。能抓,看服务器撑不撑得住;想抓,看Google判断这些URL值不值得来。你能主动控制得最多的那一个,是Google已知的URL里重复和不值得抓的比例。
对做出海站的人来说,这件事的重点不在怎么让Google多抓,在别让Google把时间花在废页上。一个站几千个URL,真正要推的可能几十个,剩下的重复版本、参数页、空搜索结果页一直在占抓取时间。这类清理归在技术SEO里做,别把它当成一个单独的技巧。抓取这一步没走通,后面的收录和排名都无从谈起。
- 它不是配额,没有设置按钮,Search Console里也找不到一个叫Crawl Budget的数字。
- 两个要素:容量上限管服务器这一头,抓取需求管Google想不想来这一头。
- 先管URL清单,合并重复、robots.txt屏蔽、404或410、清soft 404,再谈速度和sitemap。
- noindex省不了抓取,robots.txt临时腾出来的预算也不会转给其他页。
本文从定义讲到能查的入口,再给一套能照着改的顺序,最后把几个省不了预算的做法拆开说。
本文目录
Crawl Budget是什么:Google能抓和想抓的URL集合
Crawl Budget指的是Google分给单个站点的抓取时间和抓取资源。这句话里有两个动作:请求你的URL,以及决定还来不来。抓取预算就是这两件事合起来的结果,不是一张可以申请的额度。
理解它的关键在「集合」这两个字。Google心里有一份你站上URL的清单,它按这份清单安排抓取顺序和频率。清单里废页越多,好页排得越靠后。所以优化抓取预算,本质上是在改这份清单,不是在求Google多给。
官方说的「一个站」按主机名算
Google的抓取系统把一个唯一主机名当成一个站。官方原话是「The allocation of these resources is commonly called a site's crawl budget. In this context, Google's crawling infrastructure defines a site as a unique hostname.」。blog.example.com和www.example.com在它眼里是两个站,容量和需求分开算。子目录不单独成站,把内容拆到不同目录换不来第二份预算。
抓取是搜索引擎干活的第一道工序,后面才是索引和排序,整条链路在搜索引擎工作原理里讲得比较完整。放到抓取预算这件事上,只要记住一点:页面没被抓到,后面的处理都谈不上。
它不等于「每天给你N次抓取」
Search Console里没有这项数值,也没有能调的开关。你看到的是抓取统计、主机可用性和抓取请求的趋势图,不是配额面板。抓多少由系统按容量和需求实时算,站点这边看不到一个上限数字。
能主动调的只有抓取速率,而且是往下降的方向,用在服务器扛不住的紧急情况。想往上加,只有两条路:加服务器资源,或者把内容质量做上去。抓取和索引是两件事,这块的区别可以对照蜘蛛抓取与索引。
什么样的站才需要看这份指南
官方写得很直接:页面数量不多、变化不快,或者新页面发布当天就被抓走的站,不需要读这份指南。反过来,页面多、更新频繁、新内容几天都进不去索引的站,才轮到讨论抓取预算。
判断依据不在感觉,在数据。Crawl Stats里的抓取请求数、平均响应时间、可用性告警,三样摆在一起看,才知道是容量不够还是需求不足。凭「我觉得最近抓得慢」下结论,改错方向的概率很高。
为什么你的站抓得少:容量上限和抓取需求各管一头
抓得少只有两种原因。一种是Google抓不动,服务器这边到顶了;一种是Google不想抓,觉得这些URL不值得排。前者是容量问题,后者是需求问题,处理方式完全不同。
crawl capacity limit:服务器为Google保持连接多久
这个上限限制的是服务器为Google保持连接的总时长,并行连接数和每个连接的时长都算在里面。每个站的起始值相同,都是保守的默认值。站点健康、抓取需求又大,Google的系统会自动往上调。
调的方向看健康度。响应稳定、延迟和首字节时间不变或变好,上限升,能用更多连接来抓;响应变慢,或者返回5xx、429这类状态码,上限降,抓得更少。这也解释了一个反常识的现象:服务器越吃力,抓取量越是往下掉。
crawl demand:站点规模、更新频率、页面质量、相关性
Googlebot的抓取需求按站点规模、更新频率、页面质量和相关性来算,而且是拿去跟别的站比。同样的更新频率,在一个内容稀缺的领域和一个内容过剩的领域,需求不一样。
需求低的时候,就算容量没用满,Google也会少抓。这句话要记住,它意味着服务器闲着不等于Google就该多来。指望加机器解决需求问题,钱花了,抓取量不动。
你能主动控制的那一个:perceived inventory
没有你的指引,Google会尽量把它知道的所有URL都抓一遍。这些URL里有很多是重复的,或者你根本不想被抓,比如已删除的、不重要的。抓取时间就耗在这里。官方把这个因素叫perceived inventory,并且明确说这是你能正向控制得最多的一个。
说白了就一句话:Google知道的URL里废页占比越高,重要页面分到的时间越少。想让抓取集中在好页上,先减废页,不是先加服务器。
容量上限是所有爬虫共享的
每个爬虫的抓取需求不同,但容量上限是共享的。一个爬虫需求高,其他爬虫能用的容量就少。同一个站上跑多个Google产品时,这种情况会出现,图片、视频、新闻各有各的爬虫。
所以排查时别只盯Googlebot一个。日志里出现的其他Google爬虫,吃的是同一份容量,它们忙起来,你关心的那部分就慢下来。
怎么查:Crawl Stats、URL Inspection和站点日志三步
这件事不用猜。Search Console有两个入口,站点日志是第三个,三步走完,浪费在哪基本能定位。
第一步看可用性:Crawl Stats的Host availability图
打开Crawl Stats报告,看Googlebot在你站上的抓取历史,报告会标出Google遇到可用性问题的时间。在Host availability图里找请求数越过红色限制线的时段,点进图看哪些URL失败,再回头对站点当时发生了什么。
这一步出的是方向:是容量越线,还是某个路径在报错。这类基础项先做,后面的优化才有意义,具体清单在技术SEO优化教程。可用性没修,改页面是白改。
第二步测单页:URL Inspection报Hostload exceeded
挑几个该抓没抓的URL,用URL Inspection工具跑一遍。返回Hostload exceeded,意思是Googlebot抓不到它发现的那么多URL,问题指向抓取容量,不是页面内容。
这个报错比别的提示好判断,因为它把矛头直接指向服务器。看到它,先别改标题和正文,去看服务器负载和响应时间。
第三步查日志:Search Console没有按URL筛的抓取历史
要知道某个具体URL有没有被Googlebot抓过,只能看站点日志。Search Console不提供能按URL或路径筛选的抓取历史,这一点要提前知道,不然会在后台翻很久。
日志里先确认真假。用host命令对访问IP做反向DNS,域名应该是googlebot.com、google.com或googleusercontent.com,再对这个域名做正向DNS,解析回来必须是同一个IP。两步都对,才算真的Googlebot。访问量大时,用Google公布的IP段JSON列表自动匹配,列表里是CIDR格式。
数据对不上怎么回查
可用性告警的时间点跟日志对不上,回日志看状态码分布,是5xx多还是429多。5xx是服务器出错,429是限流信号,两者处理方式不一样。
日志里抓取量正常,新页面就是不进,问题不在服务器,回到perceived inventory那一节,看已知URL里的废页比例。
多大的站才轮到谈抓取预算
官方给的分类是粗略估计,不是精确阈值,用来判断自己站在哪一档,不是拿来卡线。够不上这个量级的站,先把收录和内容做好,抓取预算排不到前面。
| 项目 | 数字 | 说明 |
|---|---|---|
| 大型站门槛 | 100万以上唯一页面,内容大约每周变一次 | 官方说这是粗略估计,不是精确阈值 |
| 中型及以上站门槛 | 1万以上唯一页面,内容每天变 | 同一份分类里的估算,同样不是阈值 |
| 新页面被发现 | 至少几天 | 多数站别指望当天抓取,新闻站除外 |
| 索引时间 | 三天或更久 | 新闻站或高时效内容除外 |
| 单文件抓取上限 | Googlebot抓Search时前2MB,PDF前64MB | |
| 单个sitemap上限 | 50MB未压缩或50000个URL | 超出必须拆成多个sitemap |
抓取预算是个规模化问题。页面少、更新慢的站,讨论预算没有意义。
官方把大约500页或更少的站算作小站,这个量级可能连sitemap都不需要。sitemap帮搜索引擎发现URL,不保证全部被抓,也不保证全部被索引。小站先盯内容和收录,别把抓取预算当成第一优先级。
优化顺序:先堵浪费,再谈结构和速度
顺序错了会白花钱。先加服务器再清废页,等于给一个漏水的桶加大进水口。下面六步按这个顺序做,做完一步再看数据。
-
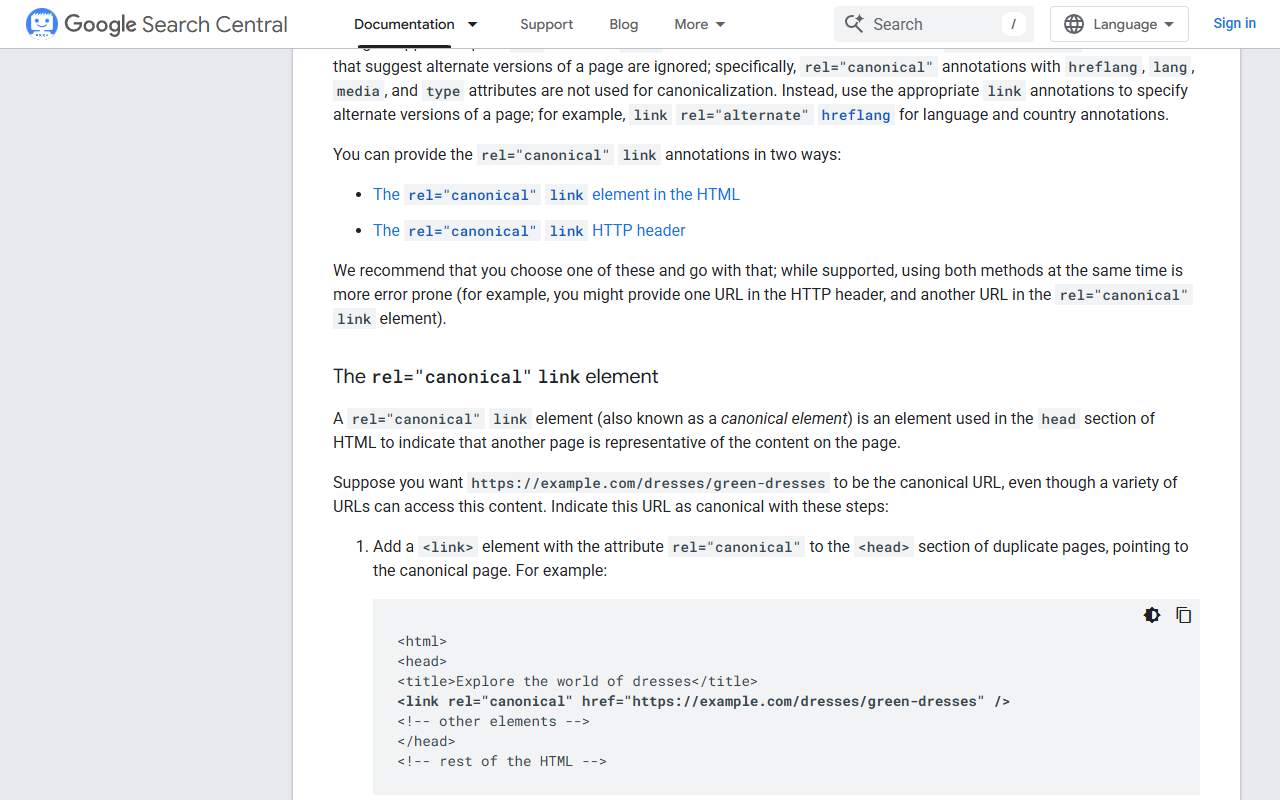
合并重复内容。用rel="canonical"指向唯一内容,规范页自身也加一条指向自己的canonical,站内链接一律指向规范URL,不要指向重复版本。官方把「避免把抓取时间花在重复页上」列为指定规范URL的理由之一。站内链接怎么写更稳,内部链接那篇讲得细。回查:改完再看Crawl Stats,看请求是否从重复路径转到规范路径。
-
用robots.txt屏蔽长期不想让Google抓的页。无限滚动页、同一个页面的不同排序版本、带会话ID的URL、动态生成的搜索结果页,都属于这一类。只屏蔽非关键资源,装饰图这类可以挡,渲染页面要用的JS和CSS不能挡。路径和目录的设计决定了会生出多少这类URL,结构层面的处理在网站结构优化。回查:看这些路径的请求量是否下降,同时确认重要路径没被误伤。
-
永久删除的页面返回404或410,不要用robots.txt屏蔽了事。Google不会忘记一个它知道的URL,但404是不要再抓的强信号;被屏蔽的URL反而会在抓取队列里留更久,解除屏蔽后还会被重抓。回查:Page Indexing报告里这些URL的状态是不是已经变成404。
-
清soft 404。页面内容是「不存在」,状态码却给200,这就是soft 404,这类页会持续被抓,一直浪费预算。到Page Indexing报告里查soft 404。常见成因是缺失的服务器端包含文件、数据库连不上、空的站内搜索结果页、没加载出来的JS文件。回查:修完抽几个URL用URL Inspection看渲染结果是否正常。
-
缩短重定向链,把HTTP缓存打开。长重定向链对抓取有负面影响。页面自上次抓取后没变,返回304 Not Modified,Google复用缓存,省下服务器处理时间,抓取效率间接变好。回查:日志里304的比例是否上来,5xx是否下来。
-
sitemap保持最新。站点有更新内容时加lastmod标签,别把不想被索引的URL放进去,也别一天多次提交同一份没变的sitemap。提交入口在Search Console的Sitemaps报告,能看到Googlebot什么时候来访问、有没有处理错误。回查:看报告里的访问时间和错误项。
六步做完,再判断要不要加钱。看Crawl Stats里的主机可用性历史,抓取速率是不是经常越过限制线;如果经常越线,增加服务资源,跑一个月,再看同期抓取请求有没有增加。这是唯一的「加资源换容量」动作,前提是浪费已经堵住。
常见误区:这几种做法省不了抓取预算
下面几条都是官方明确点出来的错误做法。判断标准很简单:看它有没有减少Google实际发出的请求。
用noindex省抓取
省不了。Google还是会请求这个URL,看到noindex标签或响应头之后才把它丢掉,抓取时间已经花出去了。想彻底不让抓,用robots.txt;只是想不让它出现在搜索结果里,才用noindex。
用robots.txt临时腾预算
腾不出来。除非Google已经达到你站的抓取容量上限,否则屏蔽掉的那部分预算不会转移给其他页面。robots.txt是给长期不想被抓的页面用的,不是调度工具。
屏蔽已经抓过的页面想转移预算
同样不成立。屏蔽或隐藏已抓页面不让重抓,预算不会转到站内其他部分,前提还是Google已经撞到你站的服务上限。这条跟上面那条经常被混着用,结果都是白折腾。
以为变快就能多抓
不成立。Google只抓高质量内容,把低质量页面变快不会让Googlebot多抓;反过来,如果它认为漏掉了高质量内容,才可能提高预算。可用性改善也不必然增加预算,但可用性出问题一定会妨碍抓取。速度本身值得做,网站访问速度优化是另一件事,别指望它直接换抓取量。
页面没被抓的四种可能
按顺序排查:Google不知道这个URL;内容被屏蔽了;站点到了服务容量上限;抓取预算用完了。四种原因的处理动作完全不同,跳着猜会浪费很多时间。系统性的排查流程可以照SEO诊断怎么做那份走一遍。
最后一句边界。刷抓取、伪造sitemap骗爬虫、隐藏文字喂蜘蛛,都属于黑帽。短期可能看到动静,站点被处理之后的恢复成本远高于这点收益。
AI能帮哪几步,人要核什么
抓取预算这件事,有一大半工作是整理和比对,这部分AI做得快,判断还得人来下。
-
日志聚类。把访问日志里的URL列交给AI,按路径模式聚类,找出参数组合最多、内容重复概率最高的几组。这一步人工看几千行会漏,AI出的是候选清单,剩下的要你自己认。
-
时段对比。把Crawl Stats导出的每日抓取请求数和平均响应时间整理成表,让AI找出抓取量下降同时响应时间上升的时段,并给可能原因。数字是它算的,结论要你回到服务器上核。
-
生成robots.txt屏蔽清单草稿。按官方规则把不该抓的路径列出来,只出草稿,不直接上线。
下面三条提示词是本文给的示例,不是官方模板,可以按自己的字段改。
第一条:「下面是我站7天访问日志的URL列(已脱敏),按路径模式聚类,标出参数组合最多、内容重复概率最高的10组,并说明判断依据。」
第二条:「这是Crawl Stats导出的每日抓取请求数和平均响应时间,找出抓取量下降且响应时间上升的时段,列成表并给出可能原因。」
第三条:「按Google官方crawl budget文档的规则,检查这份robots.txt草稿:哪些Disallow可能挡掉渲染关键资源,哪些条目属于官方明确不推荐的临时腾预算做法。」
人必须自己做的有三件。一是把Disallow路径填进robots.txt;二是挑三个栏目页,手工点一遍,看站内链接是不是都指向canonical那个地址;三是日志里那些声称是Googlebot的请求,来源没确认过之前,不要拿来下判断。整理资料、对照规则、出改稿单这类活,猎者出海的AI Agent能接过去,它能自己拉数据,每周给一张单子,写清改哪几篇、先改哪篇。
常见问题
Crawl Budget可以手动设置吗
不能。Search Console里没有这个设置项,也没有一个数值可以调。能主动调的只有抓取速率,而且是紧急情况下往下降速用的。
Crawl Budget和crawl rate是一回事吗
不是。抓取预算是容量和需求合起来的结果,抓取速率是Googlebot访问你站的频率,后者可以临时降,前者由系统算。把两者混为一谈,容易以为降速能保住预算。
小站需要关心Crawl Budget吗
多数不需要。官方说页面不多、变化不快的站不用读那份指南,大约500页或更少的站连sitemap都可能不需要。小站先把内容和收录做扎实。
新页面多久会被抓取
多数站点至少几天,索引通常是三天或更久。新闻站和时效性极强的内容除外。当天收录不要当成默认预期。
用robots.txt屏蔽页面能提高其他页的抓取吗
除非Google已经达到你站的抓取容量上限,否则不会。屏蔽只解决「这个页不要抓」的问题,不解决「把抓取挪到别处」的问题。
新闻站的抓取预算有什么不同
时效性强的站不在「至少几天」这个默认预期里,官方明确把新闻站列为例外。这不代表新闻站不用管废页,只是抓取节奏更快,出错时的损失也更直接。
抓取预算这件事,说到底是在做减法。URL清单干净了,服务器稳了,Google自然会把时间花在你真正想推的页面上;清单乱,加多少机器都是在给废页买单。每周把Crawl Stats和日志对一遍,让猎者出海的AI Agent按数据出一张改稿单,比盯着抓取总量焦虑有用得多。

发表评论