

站内有一点重复内容,Google自己都说是正常的,不违反垃圾政策。这句话让不少人松了口气,然后就不管了。真正吃亏的地方在另一头:你辛辛苦苦做的那一页,最后被评估的可能压根不是它,而是另一个地址。Duplicate Content(重复内容)说的就是同一段内容能通过多个不同URL访问到,Google在索引时用canonicalization把这类页面聚成一组,再从中选出一个最有代表性的URL作为canonical。站内有一部分重复内容属于正常情况,并不违反Google的垃圾内容政策。
对做出海站的人来说,这件事的分量在于你花力气做的那一页到底有没有被当作评估对象。Google用canonical页面作为评估内容和质量的主要来源,搜索结果通常也指向canonical页面,你首选的URL没被选中的时候,改标题、加内链、补内容这些动作有一部分落在另一个地址上。
- 是什么:同一内容能通过多个不同URL访问,Google用canonicalization选出一个代表URL。
- 官方怎么说:站内部分重复内容正常,不违反垃圾内容政策;canonical偏好是提示,不是规则。
- 怎么做:按Redirects、rel="canonical"、Sitemap的强度顺序处理,可以叠加使用。
- 要多久:修好以后,Google可能把页面留在重复聚类里最多两周。
这篇围绕一件事写:把散开的重复URL收拢到一个canonical上,以及收拢不动的时候回到哪一步回查。
本文目录
Duplicate Content 到底指什么:同一内容多个 URL,Google 选一个代表
canonicalization是给一段内容选代表URL的过程,选出来的那个就是canonical URL。Google把这个过程叫deduplication,作用是搜索结果里只展示重复内容的一个版本,不把同一个东西列好几条。
判定重复看的是主体内容,不是页面上有没有差别。两个页面标题不一样、导航不一样、页脚不一样,主体正文一样,照样会进同一个聚类。这也是为什么有些站觉得自己每页都「不一样」,查下来还是一堆重复。
哪些情况算重复
Google列出的成因有这几种,对着自己的站排一遍,大部分能覆盖:
- 地区变体:美国站和英国站用同一语言、实质相同的内容,只是用hreflang分开。
- 设备变体:同一篇内容分别给桌面端和移动端一套URL。
- 协议变体:http和https两个版本都能访问。
- 站点功能:分类页的排序、筛选结果各自生成一个URL,内容差别很小。
- 意外变体:测试版、演示版被爬虫访问到,或者带www和不带www同时可访问。
这几种里,站点功能和意外变体是自己生出来的,改代码或者加一条服务器规则就能收口。地区变体和协议变体牵扯多站和证书配置,处理顺序要往后放。
多语言页面什么时候才算重复
同一页面的不同语言版本,只有在主体内容语言相同时才算重复。翻的只是页眉、页脚和导航这些非关键文字,正文没动,这两个页面就是重复的;正文真换成了另一种语言,就不算。本地化版本同理,正文没翻译才视为重复。
这一条判反了,后面做法会全错。正文翻译过的页面去加canonical指向另一个语言版本,等于告诉Google这个语言版本不用看了。多语言站点的URL怎么排、语言目录怎么切,看多语言网站结构。
重复内容对 SEO 的影响:不违反垃圾政策,但会影响 canonical 选择
Google的原话是「Some duplicate content on a site is normal and it's not a violation of Google's spam policies.」站内有一些重复内容属于正常,不构成对垃圾内容政策的违反。但它同时写了另一面:同一内容能通过很多不同URL访问,会让使用的人不知道哪个才是对的页面,也会让你更难判断这段内容在搜索结果里的表现。
这两句话合起来就是结论。这件事不进处罚流程,进的是信号分配流程。
Google 怎么处理:聚成一组,选最完整有用的当 canonical
索引一个页面的时候,Google先确定这页的主体内容是什么。发现多个页面的内容相同,或者主体内容非常相似,就把它们聚成一类,再从这一类里挑出对搜索用户最完整、最有用的那个,标成canonical。canonical页面被抓取得最勤,重复页面抓取频率更低,这样能减少站点的抓取负载。
重定向的情况会单独记一笔。做重定向时,Google同时记录重定向来源(旧URL)和目标(新URL),最后哪个成为canonical,取决于重定向是临时还是永久这类信号。
canonical 页面作为评估来源意味着什么
Google用canonical页面作为评估内容和质量的主要来源,搜索结果通常也就指向canonical页面,除非某个重复版本对搜索用户明显更合适。这句话反过来读就是稀释。三个地址装同一篇内容,最后被评估的只有一个,通常是Google挑的那个,不一定是你想推的那个。
所以处理重复内容的目标不是躲处罚,是把信号集中到一个地址上。Canonical标签那篇讲的是标记本身怎么写,这里讲的是什么时候该用它。
重复内容怎么解决:按 Redirects、canonical、Sitemap 的顺序修
Google给的三种指定canonical的方式有强弱之分,从强到弱依次是重定向、rel="canonical"链接标注、sitemap收录。三种可以叠加,同时用两种以上,会提高你首选的canonical URL出现在搜索结果里的机会。但这三种都不是必须的,不指定偏好,站点通常也能正常运作,Google会自己判断哪个版本适合展示。
还有一条容易漏的:站内链接要指向canonical URL,不要指向重复URL。全站一致地链到你自己认的那个地址,Google才读得懂你的偏好。导航、面包屑、正文内链都算。
第一步:先用 URL Inspection 看 Google 选的 canonical 是哪个
动手之前先看现状。在Search Console的URL Inspection工具里输入URL,看Google认为哪个页面是canonical,再想一件事:它选的这个,对从搜索来的访客是不是比你的首选更合理。如果答案是是,那该改的是你的首选,不是Google的选择。
如果它选得不合理,往下查技术原因:页面上是不是有错的canonical元素,服务器配置是不是有问题,多语言站点是不是缺了本地化标注。这几条查完还没找到原因,再动页面。回查的方式一样,改完再进URL Inspection看它现在报的canonical是哪个。
第二步:弃用重复页面就上永久重定向
重定向是三种方式里信号最强的,用它的前提是你确实要弃用那个页面。永久重定向告诉Google,被重定向的URL是比目标更差的版本,所以只在不要这个页面的时候用。要最快见效就用HTTP也就是服务端重定向,301和308状态码都表示页面已经永久移到新位置。
永久重定向和临时重定向在搜索结果里的表现不一样。永久重定向展示新的目标页面,临时重定向展示来源页面。所以确认这个重定向不会被撤销了,再用永久的。上线测试阶段那种随时要回滚的情况,别急着用永久。JavaScript重定向只在做不了服务端或meta refresh的时候才用,因为渲染可能失败,Google看不到那条重定向。
PHP里用header()函数设置永久重定向,必须在向屏幕输出任何内容之前设置头。这一步顺序错了,重定向不生效,页面还会照常输出。
第三步:页面还要保留就用 rel="canonical",记得自引用
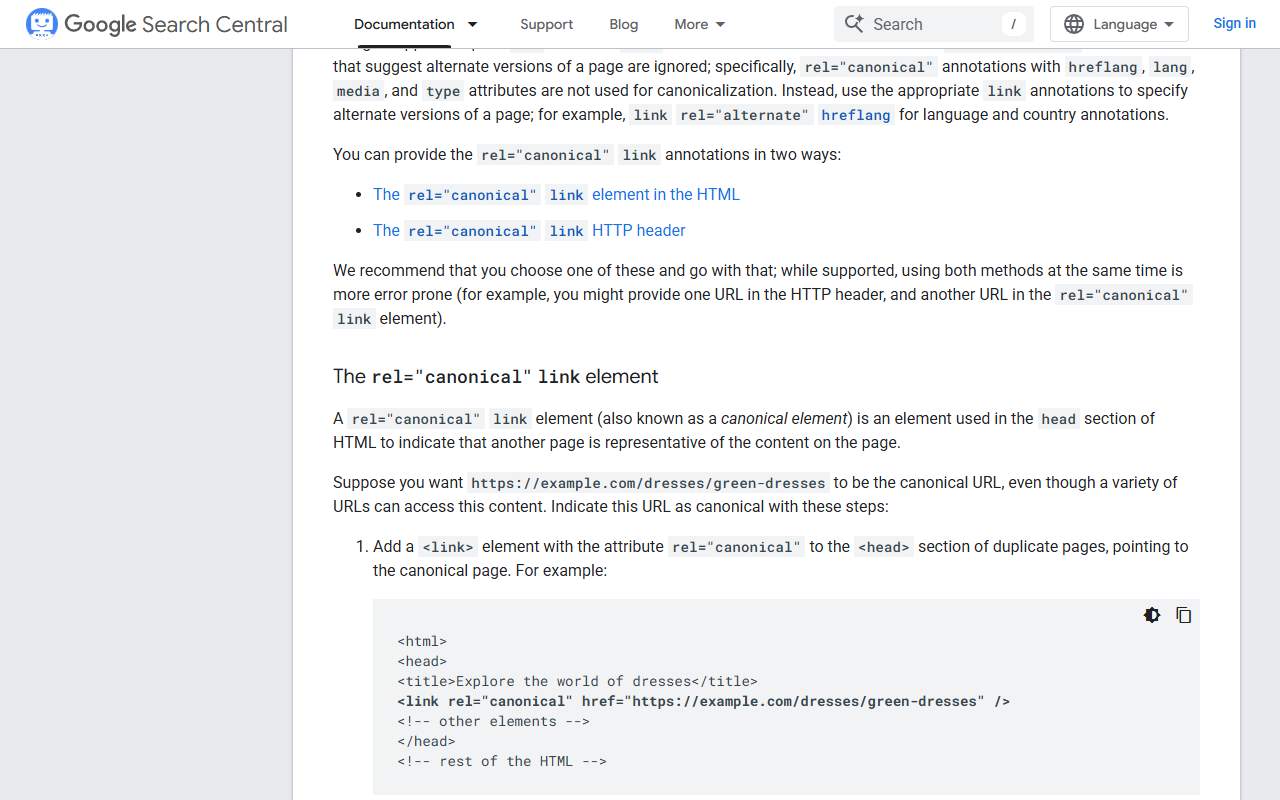
页面有价值、前后两个版本都想留着,那就别重定向,用rel="canonical"。做法是在重复页面的head部分加一个link元素,指向canonical页面。同时在canonical页面本身也放一个指向自己的rel="canonical",也就是自引用canonical,这一条是官方明确推荐的。
有几个细节要单独说。canonical建议用绝对路径,相对路径Google支持,但长期容易出问题,比如测试站被允许抓取的时候。link元素只认出现在head里的,head至少要保证是有效HTML。rel="canonical"链接元素和HTTP头两种方式选一种就好,同时用更容易出错。
带hreflang、lang、media、type属性的canonical标注会被直接忽略,不参与canonicalization,替代版本要用link rel="alternate" hreflang这类标注去写。也不要给同一个页面用不同技术指定两个不同的canonical,sitemap里写A、页面里写B就是典型的错法。URL片段不能当canonical,Google一般不支持。
PDF、Word这类非HTML文件,用rel="canonical"的HTTP头指定canonical URL,这个方式只支持在网页搜索结果里。
第四步:多语言用 hreflang,整页不该收录才用 noindex
多语言站点的问题不是重复,是分清谁该服务哪个地区的人。做法是给每个变体在head里加一组link元素,每个变体一条,包括它自己,所有版本的链接集必须完全一样。两个页面必须互相指向,X链到Y,Y也必须链回X,缺一边标注就可能被忽略或者解释错。
替代URL要写完全限定地址,带上http或https。语言代码只支持ISO 639-1里的,地区代码只支持ISO 3166-1 Alpha 2里的。不能只写国家代码,Google不会从国家推语言。没有匹配浏览器设置的版本时,用x-default指定回退页。三种实现方式从Google角度看是等价的,选一种就行,三种一起上在搜索里没有好处。
用hreflang的页面,canonical要指向同一语言的页面,同语言确实没有,再用最接近的替代语言。hreflang标签那篇讲的是写法,这里只提醒一件事:Google不用hreflang或者HTML lang属性判断页面语言,它用算法判断,别指望标了就等于翻译过了。
noindex的位置要放对。它只在整页都不该出现在搜索里的时候用,作用是让支持这个规则的搜索引擎把页面完全从结果里去掉,不管有没有别的站链它。拿它去阻止站内选canonical是错的,那会把这个页面彻底挡在搜索之外,rel="canonical"才是首选方案。
第五步:改完在 URL Inspection 里 Request Indexing,配额留给重要 URL
内容和技术都改完,去Search Console的URL Inspection工具点Request Indexing,请求Google重新评估这一组页面。这个功能有配额,留给最重要的那批URL,别一个站里挨个点。
重复内容检测:用 Search Console 两个入口找到重复 URL
检测这件事不需要额外的工具。Search Console里两个入口够用:Page Indexing报告看全站的重复分布,URL Inspection看单个URL的具体状态。
Page Indexing 报告:看 duplicate / alternate 行,标记为重复通常是好事
Page Indexing报告展示站点有多少URL被Google抓取和索引。在未索引的表里,duplicate和alternate这两行就是重复内容的结果。页面被标成duplicate或alternate,通常是好事,说明Google已经找到了canonical页面并且索引了它,被标的那一条本来就不该单独出现在结果里。
看表的时候注意Source这一列,它显示问题来源是Google还是网站自己,一般只有标成Website的那部分你能修。也不要拿100%覆盖率当目标,Google只索引canonical页面,重复URL没被索引是对的。站点少于500页的话,大概率还用不上这个报告,先用site:查几个关键页面在不在就够了。在报告里请求验证修复要一次修干净,漏一处,Google找到一个残留实例验证就会停。整站的索引健康怎么看,SEO诊断那份讲的是排查顺序。
URL Inspection:查单个 URL 的索引状态和 Google 所选 canonical
Page Indexing报告不是用来查某一页索引状态的,查具体页面要用URL Inspection。输入URL之后,两个东西最有用:这一页现在有没有被索引,Google选的canonical是哪个。
它还能看到Googlebot抓这个页面时收到的HTML。加过noindex的页面迟迟不消失,就在这里看那个标签到底有没有被抓到,标签写在JavaScript里、被robots.txt挡住、写在body里,几种情况在这里看得清楚。站内页面逐页过一遍的顺序,写在站内SEO优化里。
数字和限制:修复要等多久、报告能看到多少条
修复期要有心理准备,下面几个数字决定了你什么时候该再看一次,什么时候不用动。
| 项目 | 数字 | 说明 |
|---|---|---|
| 修好后留在重复聚类 | 最多两周 | 内容差异越清晰,分离越快 |
| Page Indexing 报告示例 URL 上限 | 1000 条 | 不保证显示某状态下的全部 URL |
| 报告验证修复耗时 | 通常最多约两周 | 某些情况会久很多 |
| 问题生命周期 | 最后一次实例消失后 90 天 | 90 天无复发才从问题表移除 |
| 站点少于这个页数可不用该报告 | 500 页 | 可先用 site: 查关键页 |
改完不用天天看,两周是一个合理的复查间隔;报告里看到的URL列表本来就不全,别拿它当全站清单用。
另外两个时间也值得记住。新页面或者新站点,Google大概要一周左右才开始抓取和索引,刚上线的页面没有动静不代表哪里错了。加了noindex的页面还挂在结果里,一种可能是Google从那之后没再来抓过,页面在互联网上的重要性不同,重访可能要几个月。
误区和排查:robots.txt、URL 移除工具、noindex 都用错了地方
这三样东西单独拿出来都正常,被当成canonicalization手段用就全错。Google在文档里把这几条列成明确不推荐,不是风格建议。
三个明确不推荐:robots.txt 做 canonicalization、URL 移除工具、noindex 阻止站内选 canonical
robots.txt这条最容易被误用。原话是「Don't use the robots.txt file for canonicalization purposes.」Google仍然可能索引被robots.txt禁止的URL,只是拿不到内容。robots.txt本身的主要用途是避免站点被请求压垮,不是把网页挡在Google之外的机制;被它禁止的页面如果被别的地方带描述性文字链过去,Google可以完全不访问页面就索引这个URL。而且在robots.txt里写noindex规则,Google不支持。
URL移除工具更彻底,也更不该用。它会把一个URL的所有版本从搜索里隐藏掉。你要的只是让A版让位给B版,结果是两个都没了。
noindex挡站内选canonical是第三种错法,它会完全阻止这个页面出现在搜索里,而rel="canonical"链接标注才是首选方案。同一种冲动还有一种变体:给同一批近义关键词各做一个页面,指望它们各自排名,结果几个页面互相抢同一批词。这种内耗的机制和排查,看关键词自相残杀。
noindex 页面还在结果里怎么查:没重抓,或 robots.txt 挡住了
两个原因,按顺序排。一是你加了规则之后Google还没抓过这一页,用URL Inspection工具请求重新抓取就能推一把。二是robots.txt挡住了这个URL,爬虫进不来也就看不到标签,得先去改robots.txt解除阻止。
确认自己的noindex有没有写对,用URL Inspection看Googlebot抓页面时收到的HTML就够了,标签在不在head里,一眼的事。
几类 canonicalization 问题,从 CMS 错标到抄袭站
前面几步都做对了,Google选的canonical还是不对,就往这几个方向查:
- 多语言站点内容实质相同,却没加本地化标注。服务不同地区、内容一样的多个站点,要按本地化站的规则加hreflang。
- CMS或者插件错误地用了canonicalization技术,指向了你不想要的URL,用浏览器开发者工具看HTML就能确认。
- 服务器配置错误。比如请求另一个域名的URL,服务器返回的是你站的内容,这会引出跨域的canonical选择。
- 站点被黑,代码里被注入3xx重定向或者跨域的rel="canonical",指向托管恶意或垃圾内容的URL。
- 联合发布。内容同步给合作方一起发,canonical链接元素不推荐用于这种场景,因为双方页面往往差别很大,最有效的做法是让合作方阻止索引你的内容。
- 抄袭站。罕见情况下算法选中的是未经许可托管你内容的外部站点URL,可以联系对方主机商要求移除,或者按DMCA向Google提交移除请求。
还有一个容易忽略的后果:canonical URL落在你没有所有权的Search Console资源里,这个重复页面的流量你一点都看不到,数据是空的,不是没流量。站点结构层面的收口,方向看网站结构优化。
AI 能帮哪几步、人要核什么
重复内容的活有两个特点:URL多,判断重复。这两件事正好是AI擅长的部分,剩下的判断和动手还是人干。
AI能帮的四步:
- 把站点导出的URL列表交给它,按Google列出那几种成因归类,标出疑似属于同一重复组的地址。
- 把URL Inspection里显示的Google所选canonical和你的首选canonical两份清单给它,让它逐条比对,列出不一致的URL和差异原因。
- 按Redirects、rel="canonical"、Sitemap的强度顺序,让它为每组重复URL出一份修复方案草稿,写清这组该用哪种方法、为什么,哪些情况要改用hreflang或noindex。
- 把hreflang集群的互指关系画成对照表,检查有没有缺返回链接的页面。
下面三条提示词是本文给的示例,不是官方模板,可以直接复制去用:
- 「下面是我站点的URL列表。请按Google官方列出的重复内容成因(地区变体、设备变体、协议变体、站点功能、意外变体)给每个URL归类,并标出疑似属于同一重复组的URL。只做分类,不要建议任何改写或伪原创做法。」
- 「这是URL Inspection工具显示的Google所选canonical列表,这是我的首选canonical列表。请逐条比对,输出不一致的URL及差异原因,按不一致数量从多到少排序。」
- 「这是同一组重复URL。请按Redirects、rel="canonical"、Sitemap的信号强度顺序,给出修复方案草稿,说明每组该用哪种方法、为什么,并标出哪些情况需要改用hreflang或noindex。」
必须人亲手做的有三件。一是在URL Inspection里逐个输入关键URL,看Google选的canonical是哪个,然后决定接受还是改自己。二是在Page Indexing报告里点开duplicate相关行,看受影响URL的明细,判断哪些该修、哪些本来就是正常重复。三是在服务器或者CMS后台实际改canonical标签、重定向规则、hreflang标注,改完在URL Inspection里点Request Indexing。这三步没有替身,AI只能告诉你改哪里,改的动作和改完的判断都在人这边。
上线之后的运营阶段,猎者出海的AI Agent会自己拉数据,每周给一张改稿单,写明改哪几篇、改什么、先改哪一篇。
常见问题
重复内容会被 Google 惩罚吗?
Google写的是站内部分重复内容属于正常,不违反垃圾内容政策。真正要留意的是被评估的页面不一定是你要的那个。
重复内容一定拖累排名吗?
不一定。Google自己会选canonical,选对了你什么都不做也可能没事。问题出在它选的那个不是你想推的页面,或者一组页面里没有明显更完整的那个。
用 robots.txt 屏蔽重复页面行不行?
不行。Google明确不推荐用robots.txt做canonicalization,被禁止的URL仍可能被索引,只是不带内容。要合并信号,用重定向或者rel="canonical"。
noindex 加了页面还在搜索结果里怎么办?
先看两个原因:Google加规则之后还没抓过这一页,或者robots.txt挡住了爬虫导致它看不到标签。前者用URL Inspection请求重新抓取,后者去改robots.txt。
多语言页面算重复内容吗?
看正文有没有真的翻译。只翻了页眉页脚、正文没动,算重复;正文换成了另一种语言,就不算。多语言之间用hreflang互指,不要用canonical把另一个语言版本收掉。
修好后多久能从重复聚类里出来?
Google可能把页面留在重复聚类里最多两周。内容和新版本差别越清晰、越显著,分离得越快。
重复内容这件事,顺序比技巧重要。先看Google选了谁,再决定是弃页面还是留页面,最后才谈标记怎么写。顺序错了,改多少遍也白改。

发表评论