

你在robots.txt里把一整个目录挡掉,Google照样能把那个目录下的URL摆到搜索结果里,只是结果下面没有描述。谷歌爬虫(Googlebot)是Google搜索使用的两类网络爬虫的统称,分Googlebot Smartphone和Googlebot Desktop,它在「发现URL、抓取、解析、入索引」这条链路里只负责「抓取」这一段。抓取和收录本来就是两件事,官方在robots.txt说明页专门警告过,别拿它当隐藏网页的手段。
做英文站的人容易把抓取、索引、排名当成一个动作,结果就在错的地方使劲:页面没被抓,跑去改标题;页面被抓了没索引,跑去改robots.txt。猎者出海做英文独立站,碰到这类问题先把「抓没抓、收没收、排不排」分开,再决定动哪里。
- Googlebot是两类爬虫的统称,一类模拟手机,一类模拟桌面。
- 通用爬虫自动抓取时始终遵守robots.txt规则。
- 阻止抓取用robots.txt,不想被索引用noindex,彻底不让访问用密码保护。
- 提交sitemap、点请求抓取都只是提示,不是命令。
- robots.txt挡不住收录,被挡的URL仍可能出现在搜索结果里。
本文讲清Googlebot是谁、干哪一段活,以及robots.txt、sitemap、Search Console三个手段各管哪一步。SEO的基础看SEO这篇,完整的谷歌SEO流程看谷歌搜索引擎SEO指南。
本文目录
谷歌爬虫是什么:Googlebot和「蜘蛛」是不是一回事
Google把爬虫定义成任何用来自动发现和扫描网站的程序,robot、spider都是它的叫法。所以你听到的「谷歌爬虫」「Googlebot」「搜索引擎蜘蛛」,指的都是同一类东西。叫法不同,不影响它干的事。
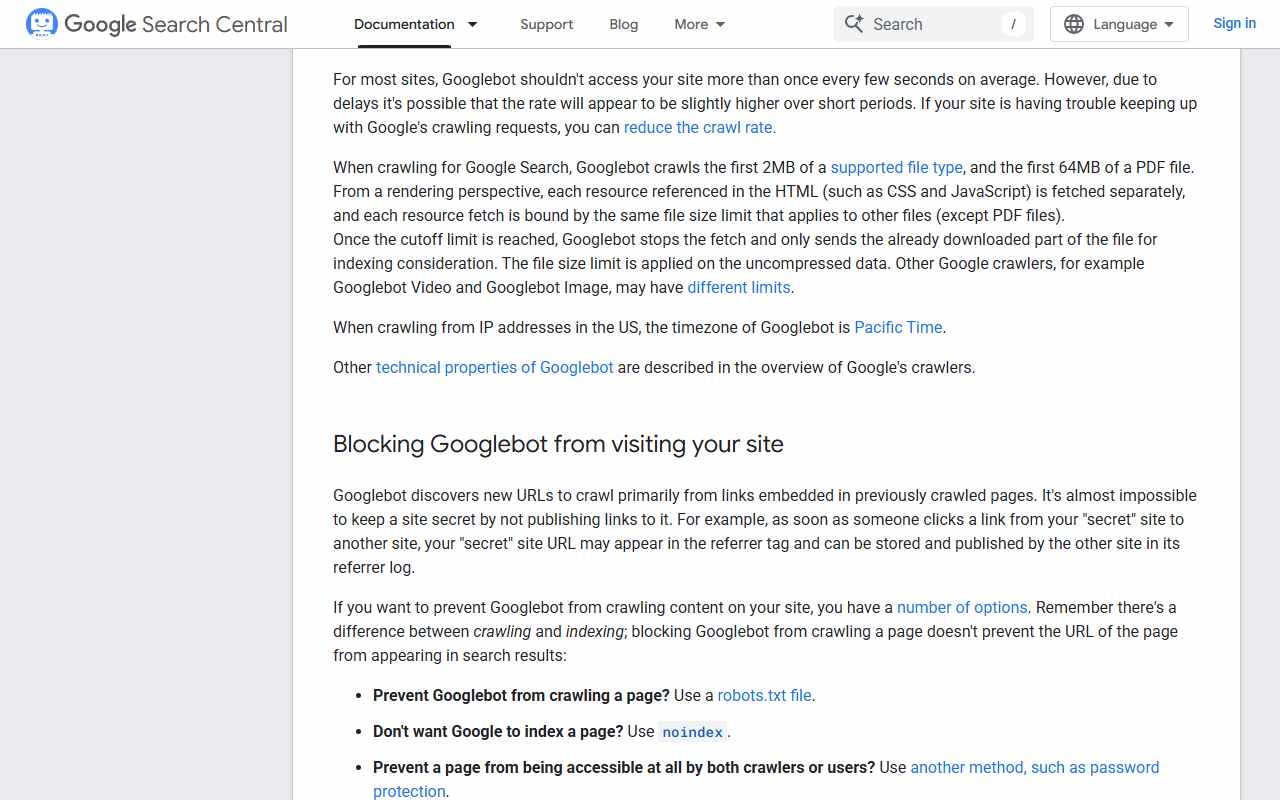
Googlebot本身是Google搜索使用的两类网络爬虫的统称。一类是Googlebot Smartphone,模拟移动设备上的用户;另一类是Googlebot Desktop,模拟桌面上的用户。两类爬虫抓的是同一批页面,站的角度不一样。
这两类爬虫在robots.txt里认同一个product token。你没法用robots.txt只挡移动爬虫、放桌面爬虫,也没法反过来。规则写一条,两边一起生效。想分开处理,靠robots.txt做不到。
Google的客户端分三类
Google的客户端分三类:通用爬虫、特殊用途爬虫、用户触发的fetcher。Googlebot属于通用爬虫,自动抓取时始终遵守robots.txt规则。这类爬虫服务的是Google搜索这类通用产品。
特殊用途爬虫服务特定产品,抓取方和被抓网站之间有约定。AdsBot就是一个例子,它在广告发布者许可下会忽略robots.txt里的全局*用户代理。用户触发的fetcher由终端用户发起,比如Google Site Verifier按用户请求执行。三类客户端的行为边界不一样,看日志时别混。
多数抓取请求来自移动爬虫
Google搜索对多数网站主要索引移动版内容,所以Googlebot的抓取请求多数来自移动爬虫,少数来自桌面爬虫。这个事实对做站的人有用:页面在手机上打不开、排版乱、正文被弹窗挡住,移动爬虫看到的就是这个样子。桌面看着正常,不代表抓取时正常。
从抓取到索引再到排名,整条流程写在爬虫索引排名全流程这篇里,这里只把Googlebot负责的那一段拆出来。
谷歌爬虫工作原理:Googlebot在四步流程里只干「抓取」这一段
把Google处理网页的过程拆开,是四步:发现URL、抓取、解析、入索引。Googlebot只在第二步干活。后面两步是别的系统在做,它不参与。
发现URL:主要靠之前抓过的页面里的链接
Googlebot发现新URL,主要来源是之前抓取过的页面里嵌入的链接。你发了一篇新文章,站内没有任何页面链到它,外部也没有链接,它被发现的路径就很窄。sitemap和Search Console的请求抓取是另外的入口,后面单独讲。
这也解释了一个现象:同样发了十篇文章,有的很快有动静,有的很久没反应。差别往往不在文章写得多好,在于有没有入口让Google知道这个地址存在。站内导航、相关推荐、分类页,都是入口。
抓取:发请求把页面取回来
发现之后,Googlebot向服务器发请求,把页面内容取回来。它由成千上万台机器同时运行,分布在全球多个数据中心,所以你日志里看到多个IP访问是正常的。Google主要从美国IP出网,从美国抓取时用的是太平洋时区。如果检测到网站屏蔽美国请求,它可能尝试从其他国家IP抓取。
协议上,Google爬虫和fetcher支持HTTP/1.1和HTTP/2,默认用HTTP/1.1。用HTTP/2抓取能省网站和Googlebot的计算资源,但官方明确说没有产品层面的好处,比如没有搜索排名提升。内容编码支持gzip、deflate、Brotli。这些是服务器配置层面的事,不会因为换了协议就多给流量。
解析和入索引不归Googlebot管
抓取和索引是两件事。Googlebot把页面取回来,后面的解析、理解、决定收不收进索引,是另一套系统在做。把这两步混成一个动作,就会得出「没被抓就是没收录」「挡了抓取就不会被收录」这类错误结论。
还有一层:Googlebot不判断你的内容好不好,也不决定排第几。它只负责把页面拿回去。内容质量、外链、搜索意图这些,是索引和排名阶段的事。抓取出问题,先修抓取;抓取正常还没流量,再往后面找原因。
四步流程的文字说明
用文字画出来是:发现URL,Googlebot抓取,系统解析,系统决定是否入索引。中间这一步才是Googlebot的活。它前面靠链接和提交入口,后面靠另一套系统判断。做站的人能直接控制的,是让它发现得到、抓得到、抓得顺。
为什么你的页面没被抓:先分清「抓取」和「索引」两件事
页面没出现在搜索结果里,先别急着改标题改内容。先确认是没被抓,还是抓了没被索引,还是索引了没排名。三种情况的处理动作不一样,弄反了就是白忙。
阻止抓取不等于阻止收录
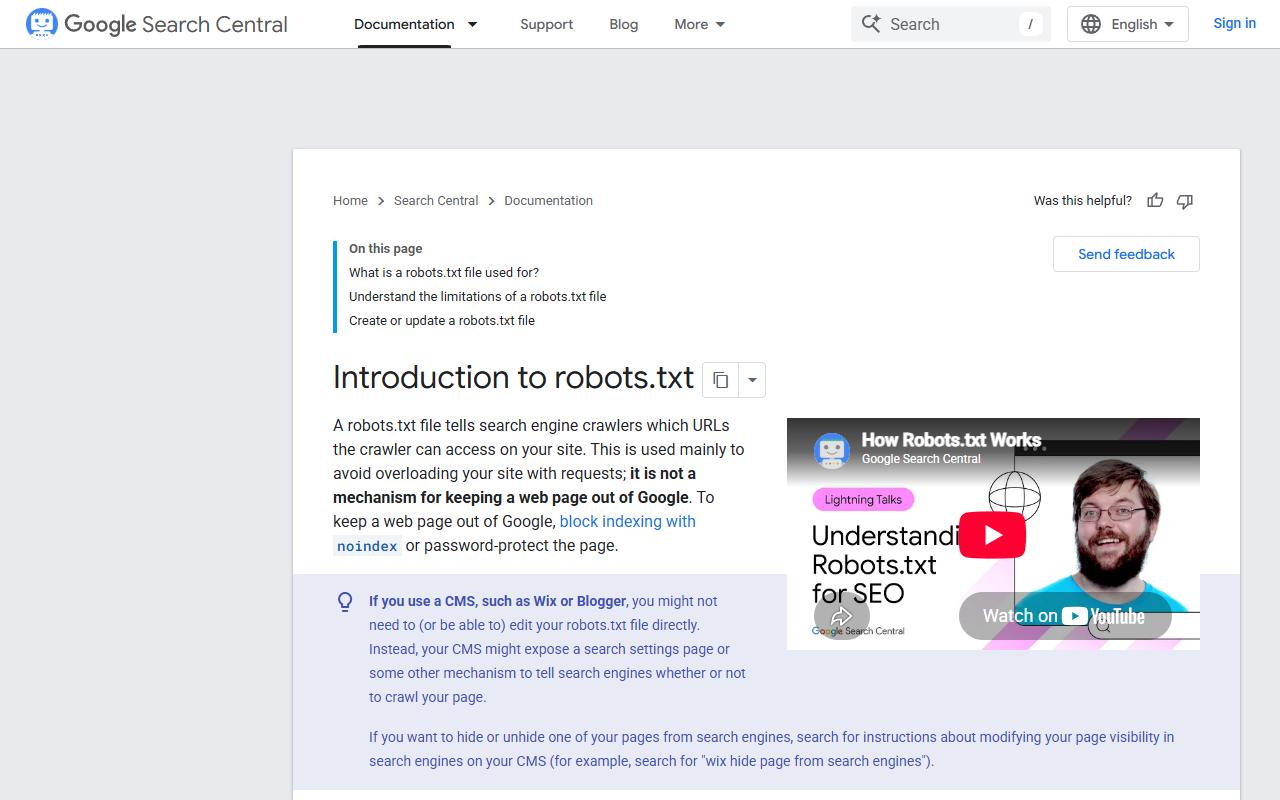
Google的说明里有一句:「If your web page is blocked with a robots.txt file, its URL can still appear in search results, but the search result won't have a description.」意思是页面被robots.txt挡住,URL仍可能出现在搜索结果里,只是没有描述。这句是整篇的地基,后面所有控制手段都从它推出来。
为什么会被收录?因为Google不一定需要访问页面才能知道这个URL存在。别的页面链到它,锚文本和周围文字就是信息。它拿这些信息拼出一个结果,哪怕没读到正文。
被disallow的页面若被别的站链接,仍可能被索引
robots.txt里disallow一个页面,只是不让爬虫抓。如果这个页面被其他网站链接,它仍可能被索引。你挡的是「看内容」,不是「知道有这个地址」。这两件事分开了,很多「明明挡了怎么还在」的疑惑就通了。
挡住Googlebot会连带影响其他产品
阻止Googlebot不只影响Google搜索。官方写得很清楚,它会影响Google搜索(包括Discover和所有搜索功能),也会影响Google图片、Google视频、Google新闻这些产品。一个robots.txt写错,损失的不是一个入口。
所以挡之前先想清楚:是只想让这个页面别出现在搜索结果里,还是连图片、视频、新闻入口一起不要。目的不一样,用的手段不一样。
组合多条规则会互相抵消
官方有一条提醒:把多条抓取和索引规则组合在一起,可能让某些规则抵消另一些规则。比如一个页面既被robots.txt挡住,又写了noindex。noindex需要爬虫抓到页面才能读到,爬虫进不来,这条noindex就起不了作用。
规则不是越多越好,是要知道每条在哪一步生效。抓取阶段的规则管「进不进门」,索引阶段的规则管「收不收进库」。顺序错了,后一条就白发。
怎么控制谷歌爬虫:robots.txt、noindex、密码保护各管哪一步
三个手段对应三个目的,别混着用。Google的原话把三件事分得很清楚:阻止Googlebot抓取页面用robots.txt,不想让Google索引页面用noindex,不想让爬虫和用户访问页面用密码保护这类方式。
| 你想达到的目的 | 用什么 | 它管哪一步 |
|---|---|---|
| 不让Googlebot来抓这个页面 | robots.txt | 抓取 |
| 让Googlebot能抓,但不收进索引 | noindex meta标签或响应头 | 索引 |
| 让爬虫和用户都打不开 | 密码保护 | 访问 |
选错行,动作就白做。用robots.txt去管收录,是拿抓取的工具干索引的活,页面照样可能出现在结果里。用noindex去管抓取,爬虫被robots.txt挡在外面,读不到这条指令,也白写。
再说细一点。robots.txt主要用来避免网站被请求压垮,它管的是抓取流量。noindex写在页面里或者响应头里,爬虫得先抓到页面才能读到这条指令。密码保护最彻底,页面根本打不开,爬虫和用户都拿不到内容。
还有一个容易忽略的点:robots.txt的指令没法强制爬虫遵守,是否遵守取决于爬虫本身。不同爬虫对语法的解释也不一样。它是约定,不是防火墙。真要保密,用密码保护服务器上的私有文件。
出问题怎么回查
页面还在搜索结果里,先看它有没有描述。有描述,说明Google抓到了页面,问题在索引或排名。没描述,只有一行URL,很可能是被robots.txt挡住了,但URL通过外链被Google知道了。按这个分叉倒查:最近有没有改robots.txt,有没有给页面加noindex,有没有同时用两条规则。
反过来的情况也要查:页面从搜索结果里消失了,先确认是抓取被挡、索引被撤,还是页面本身返回了错误的HTTP状态码。给Google爬虫返回不合适的响应码,会影响网站在Google产品里的呈现。
蜘蛛抓取本身怎么发生,写在蜘蛛抓取这篇里。先看清抓取这一段,再决定挡哪一步。
怎么让谷歌爬虫快点来抓:sitemap和Search Console怎么用
先说清楚:这里的动作是「告诉Google有这个URL」,不是「命令它马上来」。提交sitemap和请求抓取都只是提示。提示有没有用,要看后面Google自己的判断。
第一步:URL少,用URL Inspection工具请求抓取
单个或少量URL,用Search Console的URL Inspection工具。前提是你必须是该资源的所有者或完整用户,而且不能为不归自己管理的URL请求索引。填URL,点请求索引,看返回提示。有配额限制,同一个URL反复点不会更快。
第二步:URL多,提交sitemap
URL数量大,用sitemap。在Search Console的Sitemaps报告里提交,能看到Googlebot什么时候访问了这个sitemap,也能看到潜在的处理错误。sitemap是Google发现网站URL的重要方式,但它只是提示,不保证Google会下载,也不保证里面的每一条都会被抓取和索引。
用WordPress、Wix、Blogger这类CMS的,CMS很可能已经自动生成了sitemap,你不用额外做什么。URL少于几十个的sitemap可以手动建,超过几十个的最好让网站程序自己生成。robots.txt里也可以写sitemap路径,Google下次抓取robots.txt时会发现它,写多条没有数量限制。
第三步:看进度
提交完不是结束。用Index Status报告或URL Inspection工具看进度。抓取本身要时间,不是点完按钮就来。等的时候别再重复提交同一个URL,那不会加速。官方也写了,对同一个URL多次请求重新抓取,不会让它抓得更快。
出问题怎么回查
提交了没反应,按这个顺序看:sitemap地址能不能正常打开、Sitemaps报告里有没有处理错误、URL Inspection里这个URL是不是「已发现但未抓取」。如果sitemap本身有错,用Search Console排查。如果URL被robots.txt挡着,先解决挡的问题,再谈抓取。
sitemap是什么、怎么写,见XML站点地图这篇。Search Console从注册到提交的入门操作,见GSC新手入门。
数字和限制:Googlebot抓多少、sitemap多大、要等多久
下面这些是官方写明的限制,做站时拿来对一下,不用记,用到时回来看。
| 项目 | 数值 |
|---|---|
| Googlebot为搜索抓取单个受支持文件 | 前2MB |
| Googlebot抓取PDF | 前64MB |
| 爬虫和fetcher默认单文件上限 | 前15MB,超出忽略 |
| 单个sitemap上限 | 50MB(未压缩)或50,000个URL |
| sitemap索引文件loc标签上限 | 50,000个 |
| 抓取所需时间 | 几天到几周 |
| 官方口径里的「小网站」 | 约500页或更少 |
落到动作上就三句话:页面别做得太大,重要内容别堆在文件很靠后的位置,sitemap别想一个文件塞下全站。超过限制的部分,Googlebot不会等。
文件大小按未压缩数据算,不是压缩后的体积。HTML里引用的CSS、JavaScript这类资源是单独抓取的,每次抓取受同样的文件大小限制,PDF除外。
抓取频率上,官方说多数站点Googlebot平均不应超过每几秒访问一次,短时间内的速率可能看起来略高。Google的目标是每次访问尽可能多地抓页面,同时不让服务器过载。网站跟不上请求时,可以降低抓取速率。
常见误区和排查:robots.txt挡不住收录,user-agent也可能是假的
这一节把几个容易做错的动作拆开,每条先给结论,再说依据。撞上了就按后面的步骤回查。
误区一:用robots.txt隐藏网页
结论:挡不住。官方在robots.txt说明页专门警告过,不要把robots.txt当成把网页从搜索结果里隐藏的手段,PDF和其他Google支持的文本格式也一样。它挡的是抓取,不是「这个地址被Google知道」。
误区二:以为robots.txt能强制爬虫遵守
结论:不能。robots.txt里的指令没法强制爬虫行为,是否遵守取决于爬虫本身。它适合管理抓取流量,不适合当保密工具。真要保密,用密码保护服务器上的私有文件。
误区三:user-agent写Googlebot就是Google
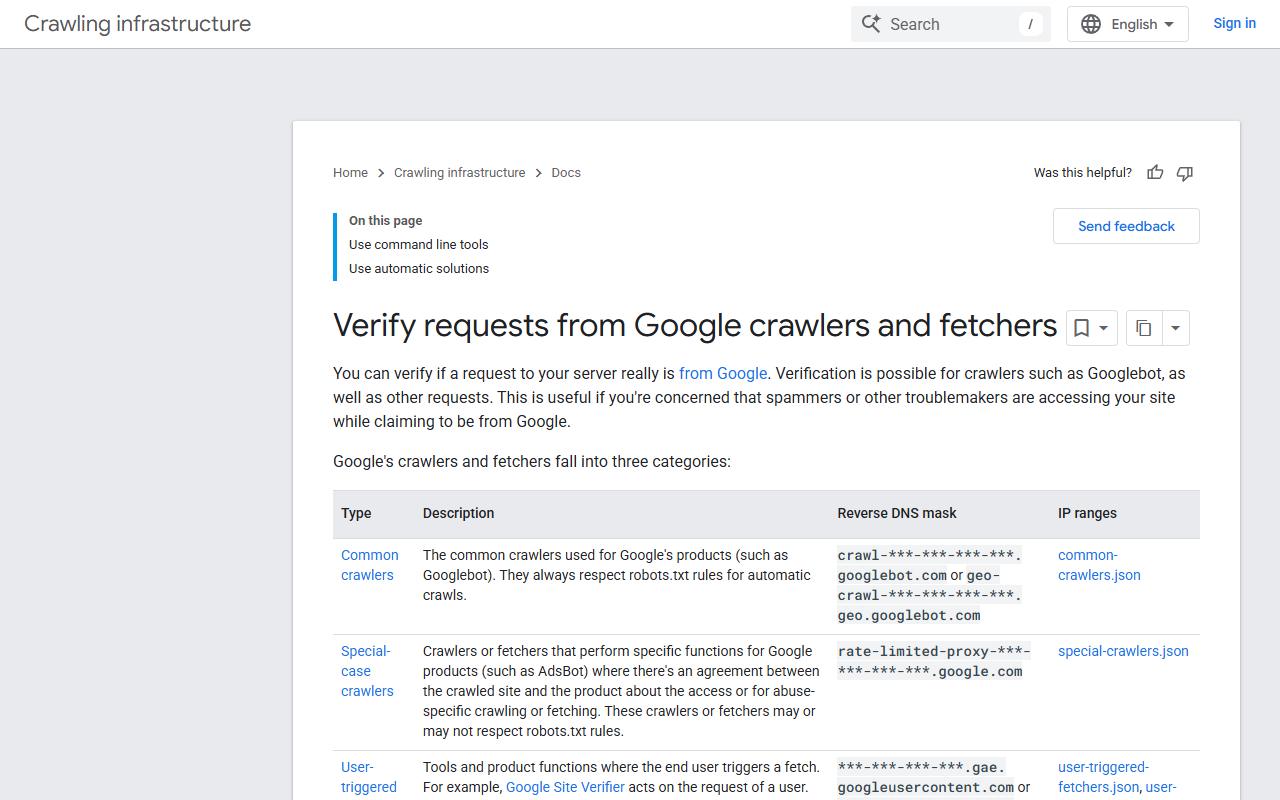
结论:不一定。Googlebot使用的HTTP user-agent请求头经常被其他爬虫伪造。验证请求是不是真来自Google,最好的方法是对来源IP做反向DNS查询,或者把来源IP和Googlebot的IP段比对。只看user-agent字符串就封IP,可能封错人。
排查:一条一条验证
- 打开服务器日志,挑一条声称是Googlebot的访问记录,记下来源IP。
- 用host命令对这个IP做反向DNS查询。
- 看查到的域名是不是googlebot.com、google.com或googleusercontent.com之一。
- 对查到的域名做正向DNS查询,确认结果和日志里的原始IP一致。
四步都对上,这条请求才可信。大规模验证可以用自动方案,把爬虫IP和Google公布的IP段列表比对,JSON文件里的地址是CIDR格式。
误区四:sitemap里写priority、changefreq有用
结论:没用。Google忽略这两个值。lastmod只有在持续准确、能和页面最后修改时间对上时才被使用。URL在sitemap里的顺序也不重要。sitemap文件必须用UTF-8编码,里面的URL要用完整的绝对地址,Google会严格按列出的地址抓取。
robots.txt的具体写法见robots.txt这篇。抓取量怎么不浪费,见Crawl Budget。
AI能帮哪几步、哪几步必须你自己动手
AI在这件事上适合做整理和对照,不适合替你做提交和验证。下面三步是它能接的。
- 把「发现URL、抓取、解析、入索引」画成文字流程图,标出Googlebot只负责抓取这一段。你拿去检查自己的理解有没有漏。
- 把robots.txt、noindex、密码保护三个手段整理成对照表,每一行只写官方原句里有的作用。整理完你对着表检查站上现在用的是哪一条。
- 把官方原句里的数字抽成清单,保留单位和原句,方便你写站内规范时引用。数字对不对,最后还要回官方原句核一遍。
下面三条提示词是本文给的示例,不是官方模板,可以直接复制改。
「用一句话说清Googlebot在发现URL、抓取、解析、入索引四步里只干哪一步,不要提排名。」
「把robots.txt、sitemap、Search Console三个手段分别对应到抓取流程的哪一步,列成三行表格,每行只写官方原句里有的作用。」
「把这段官方原句翻译成大白话,保留所有数字和单位,不加原文没有的结论:<粘贴原句>。」
必须你自己动手的有三件:在Search Console的Sitemaps报告里填地址、点提交,看返回状态是成功还是报错;在URL Inspection工具里填一个URL、点请求索引,看有没有提示配额或权限不足;打开服务器日志挑一条IP,做反向和正向DNS,判断这条请求是真Googlebot还是伪造。这三件都要登录你的账号、看你自己的数据,AI替不了。
整理资料、对照官方文档、出改稿单这类活,可以交给猎者出海的AI Agent。它按技术SEO的规则帮你把该查的项列出来,提交和验证还是你点。
常见问题
谷歌爬虫是什么意思?
就是Google用来自动发现和抓取网页的程序,正式名字叫Googlebot。它分移动和桌面两类,在搜索流程里只负责抓取,不负责决定收录和排名。
需要给网站做sitemap吗?
站点小、内部链接齐全,通常不需要额外做,Google一般能顺着链接发现大部分页面。站点大、刚上线外链少、有大量图片视频或新闻内容,sitemap能改善抓取。用CMS的话,多数平台已经自动生成了。
怎么让Google重新抓取我的页面?
少量URL用Search Console的URL Inspection工具请求索引,大量URL提交sitemap。请求不保证马上被抓,也不保证一定进搜索结果,同一个URL反复请求不会更快。
用WordPress这类CMS还要自己提交sitemap吗?
多数情况下CMS已经把sitemap生成好了,也自动把新内容提交给搜索引擎,你先去平台的支持文档确认。要自己提交也可以,在Search Console的Sitemaps报告里填地址。
怎么确认访问我网站的是不是真的Googlebot?
对来源IP做反向DNS查询,看域名是不是googlebot.com、google.com或googleusercontent.com,再正向查一次,确认IP对得上。只看user-agent不行,那个请求头会被伪造。
robots.txt能挡住图片、视频、PDF吗?
能影响抓取。被挡页面里嵌入的图片、视频、PDF和其他非HTML文件也会被排除抓取,除非被允许抓取的其他页面引用了它们。但它挡不住别的页面或用户链接到这些文件。
抓取和索引是基础动作,弄对之后才是每周看数据、改页面。猎者出海的AI Agent会自己拉数据,每周给一张改稿单,告诉你先改哪几篇。基础规则还是得你自己先弄对。

发表评论