

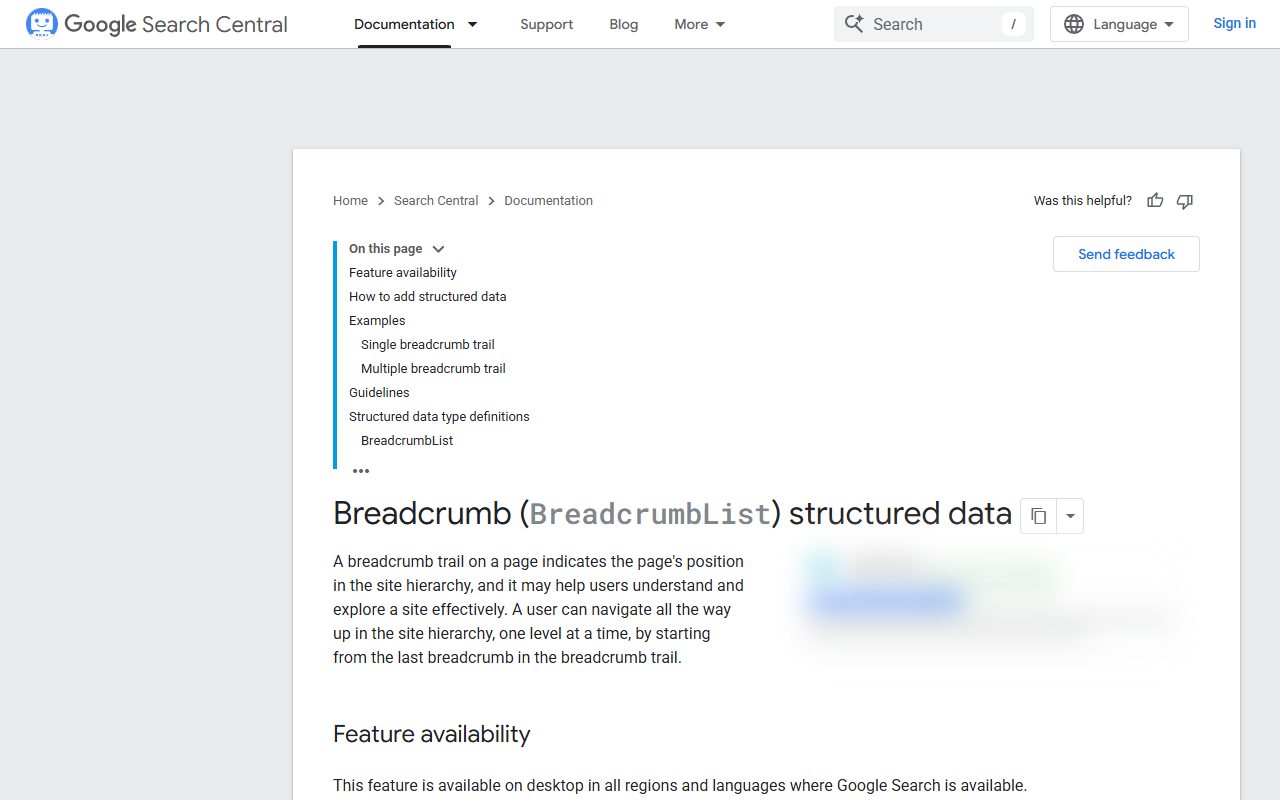
面包屑导航是页面上那条显示层级位置的导航,形如「首页 > 分类 > 子分类 > 文章」。Google的定义是它表示页面在站点层级中的位置,读者可以从最后一项开始,一级一级往上走。Google会用页面正文里的面包屑标记(BreadcrumbList)在搜索结果里给页面信息归类。标记写对了也不保证一定出富结果。
对做出海站的人来说,面包屑是最省事的一条站内链接来源,每个内页都能从上一级页面拿到一条指向它的链接。它归在网站结构这一层,结构定完顺手就装,不用等站做大了回头补。
- 面包屑是什么:页面在站点层级里位置的导航条,最后一项是当前页,前面几项能点回上一级。
- 对SEO的三件事:给内页补站内链接,帮读者定位,用BreadcrumbList让搜索结果给页面归类。
- 怎么做:加必填属性,用Rich Results Test验证,再用URL Inspection看Google读到的版本。
- 要多久:页面发布后,Google找到并抓取它可能要几天。
这篇讲清楚面包屑的定义、对SEO的作用、BreadcrumbList的写法、WordPress装法和上线后的验证。想按顺序系统学Google SEO,入口在Google SEO学习地图。
本文目录
面包屑导航是什么:页面在站点层级里的位置条
面包屑这个词是从英文breadcrumb直译的,落到网站上就是一条层级路径。Google在搜索外观文档里把它归在导航这一类,说的是页面在站点层级中的位置。
官方原句怎么定义
Google面包屑文档开头写的是「面包屑路径表示页面在站点层级中的位置」,后面接着讲它能帮用户理解和探索站点,读者可以从最后一项开始,一级一级往上走。这句话有两层意思:面包屑说的是层级,不是分类标签;它的用法是从下往上退,不是从首页往下点。
适用范围是桌面端、所有提供Google搜索的地区和语言。你装完在手机上打开自己的页面看一眼,显示正常就行,读者该看到的那条路径别在小屏上被挤掉。
一个文字示例长什么样
「首页 > 分类 > 子分类 > 文章标题」,这就是最标准的形态。前面每一项都是链接,点「分类」就回到分类页;最后一项是当前页面的标题,读者已经在这里了,通常不带链接。分隔符用大于号还是斜杠都行,一个站统一成一种。
层级深浅不固定。产品站可能是「首页 > 产品 > 分类 > 具体型号」,博客站可能只有「首页 > 分类 > 文章」。多一层少一层不决定对错,跟站的实际结构对上才算数。
它和导航菜单、侧边栏不是一回事
导航菜单是并列的入口,首页、关于、文章列表摆在同一层;面包屑是纵向的路径,从首页一路走到当前页。侧边栏放的是推荐阅读和分类列表,跟当前页在哪一层没有关系。三样东西可以同时出现在一个页面上,各干各的活。
面包屑对SEO的具体影响,拆开写在面包屑导航对SEO的作用这篇里。
面包屑导航的作用:对SEO就三件事
把面包屑的价值拆开,能落到实处的只有三件:给页面补链接、帮读者定位、让搜索结果给页面归类。别的说法大多是这三件的变形。
第一件:给每个页面补一条站内链接
Google链接文档里有一句,你关心的每个页面都应至少从站内另一个页面获得一条链接。面包屑正好干这件事:它让每个内页都有一条从上级页面过来的链接,不用你手动去正文里加。
前提是那条链接得是真链接。Google只可靠抓取带href属性的a元素,其他格式写出来的链接,大多解析不出来。有的主题把面包屑渲染成一串span加JavaScript跳转,读者点得动,爬虫读不到,那这第一件事等于没做。
回查的办法是用URL Inspection看Google渲染后的HTML,找面包屑里的文字在不在a标签里。不在,就去主题或插件里找原因,别在正文里补一堆链接把问题盖过去。
正文里的链接怎么加,写在内链怎么做这篇里。
第二件:让读者知道自己在哪,能点回上一级
从搜索结果点进来的人,落地页往往不是首页。他不知道自己到了哪一层,面包屑给的就是这个答案。前面几项能点,他想看同类文章,点上一级分类就行,不用退回首页重新找。
锚文本照层级名写。「首页 > 建站 > WordPress」这样写,读者一眼看出层级;写成「首页 > 建站 > 建站教程推荐 > 建站教程大全」,层级就散了,读者也分不清哪个是分类名。
第三件:让搜索结果给页面归类
Google用页面正文里的面包屑标记,在搜索结果里给页面信息归类。标记写对之后,搜索结果里那条地址上方有时会出现一条层级路径,替掉原本一长串URL。这是富结果的一种,意思是搜索结果比普通条目多显示一点信息。
面包屑的层级跟URL路径最好是同一套。读者看到的面包屑和地址栏对不上,会以为自己走错了地方。层级怎么分,跟站的整体结构一起定,网站结构优化讲的就是这个排法。
BreadcrumbList标记怎么写:JSON-LD示例和三条硬规矩
面包屑标记的结构不复杂:一个BreadcrumbList容器,里面放itemListElement列表,列表里每一项是ListItem,带position和name,除最后一项外再带item。就这几样,写的时候照Google示例的字段名走。
最小结构长这样
下面是两级路径的写法,名字和地址换成你自己页面的。
{"@context": "https://schema.org", "@type": "BreadcrumbList", "itemListElement": [{"@type": "ListItem", "position": 1, "name": "Books", "item": "https://example.com/books"}, {"@type": "ListItem", "position": 2, "name": "Award Winners"}]}
position从1开始往下排,name是读者在页面上看到的字,item是这一项对应的地址。三层四层就往列表里接着加,position一次加1。整段标记放在它描述的这个页面上,别在首页统一输出全站的面包屑。
最后一项为什么不带item
最后一项就是当前页面,读者已经在上面了。Google示例里Award Winners只有name和position,没有item,就是这个道理。加一个指回本页的链接不算错,只是没必要。
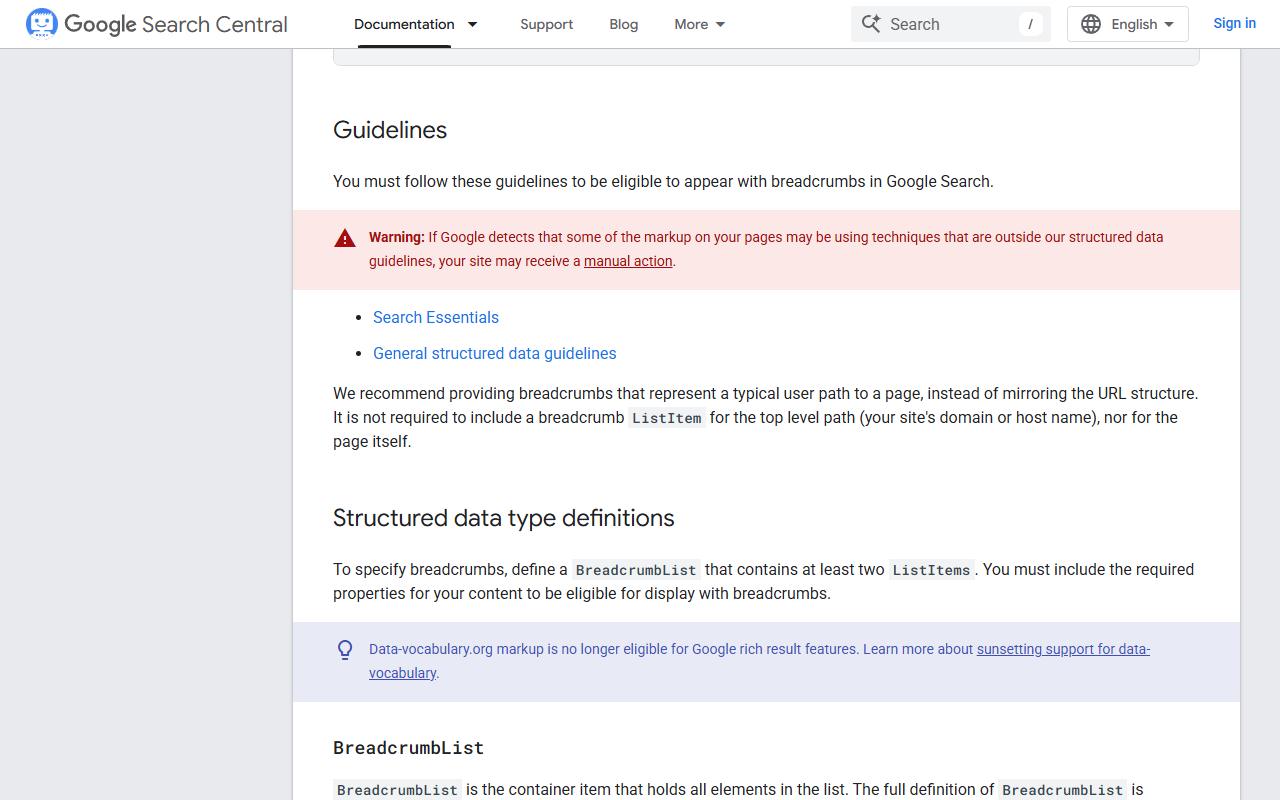
三条硬规矩
- 标记描述的内容,读者在页面上必须看得见。JSON-LD里写了一个分类,HTML正文里就得有那个分类。
- 结构化数据必须真实代表页面内容,不要标不相关或者可能误导的东西。
- 结构化数据放在它描述的页面上,除非功能文档另有说明。
三条里最容易踩的是第一条。为了让面包屑好看,在标记里加上页面上没有的层级,读者看不见,标记写得再全也不作数。还有一条:不要用robots.txt、noindex或者其他访问控制方式把带结构化数据的页面挡住。
格式选JSON-LD还是Microdata
Google推荐JSON-LD,理由是站长大规模实施和维护最省事,也更少出用户错误。它同时写了,JSON-LD、Microdata、RDFa三种格式只要标记有效、按功能文档实施,对Google一样好。所以这事不用纠结,插件输出哪种就用哪种。
报错怎么回查
Rich Results Test里看到错误或者警告,多半是语法错误或者少了属性。常见的是JSON-LD少一个逗号、引号套错、position没写。改完重新测,严重错误必须清掉,警告能改就改,改不掉不影响获得富结果的资格。
还有一种情况:一个页面有多条到达路径时,可以给它写多条面包屑路径。多数站用不上,知道有这回事就行。
WordPress面包屑怎么装:插件两条路和后台设置入口
Google的建议是,用CMS的话,用集成到CMS里的插件可能更省事。落到WordPress上,常用的是Breadcrumb NavXT和Yoast SEO这两条路。
路线一:Breadcrumb NavXT
这个插件生成的是位置型面包屑,按页面层级排,不按发布时间排。装完激活,有三种方式让它显示:用插件自带的小工具,用名为Breadcrumb Trail的区块,或者在主题(子主题)里直接调用面包屑路径。设置入口在后台Settings > Breadcrumb NavXT,层级、分隔符这些都在里面调。
它输出的是RDFa格式、兼容Schema.org BreadcrumbList的面包屑。也就是说你不用另外手写JSON-LD,插件已经把标记一起生成了。这是它跟主题自带面包屑最大的区别。装之前先确认主题自己有没有输出,有的话别让两边都往页面上写。
路线二:Yoast SEO
Yoast SEO提供面包屑区块,用来改善导航。插件页面上的说法是它给访客和爬虫提供完整的面包屑控制。它的更新节奏是每2周一次,跟着搜索引擎的变化走。站上已经在用Yoast的,先看它自带的面包屑够不够用,不够再考虑加第二个插件。
装完先对三件事
- 前台打开一篇文章,看面包屑在不在页面上。不在就是没接上,先解决显示问题,别急着测标记。
- 用区块主题的,看Breadcrumb Trail区块有没有放进文章模板或者页头模板。放错位置不显示。
- 进后台设置页,逐项过一遍层级、分隔符、要不要显示分类和标签。默认设置出来的路径不一定是你想要的。
装之前先把层级和地址定下来,这两样是绑在一起的,地址改了面包屑跟着改,返工比一开始想清楚贵得多。站现有的地址怎么排,网站URL结构讲得更细。
只想给部分页面加,会卡在哪
Breadcrumb NavXT有一条用户评价提到它不支持短代码,只想给部分页面加面包屑的时候很不方便。你也只需要少数几个页面显示的话,装之前先想好模板里怎么加判断条件,别装完再折腾。
数字和限制:装之前要对的几个数
环境和版本这两样,装之前对一眼,省得装完发现跑不起来。
| 项目 | 数字 | 说明 |
|---|---|---|
| Breadcrumb NavXT 7.0及更新版本 | PHP 7.0 | 版本门槛 |
| Breadcrumb NavXT 5.2及更新版本 | PHP 5.3 | 版本门槛 |
| Breadcrumb NavXT 5.1.1及更旧版本 | PHP 5.2 | 版本门槛 |
| Breadcrumb NavXT最新版 | 7.5.2,2026年8月29日 | 版本和发布日期 |
| 页面发布后Google找到并抓取 | 可能要几天 | 期限 |
| WordPress推荐环境 | PHP 8.3或更高,MySQL 8.0或MariaDB 10.11或更高 | 环境门槛 |
跟你直接相关的是两行:你装的插件版本要求哪个PHP,站的环境够不够WordPress推荐的配置。最后那个期限说的是页面发布之后的事,不是插件生效时间,两件事别混着看。
插件页面上的评价有132条,带日期,翻一遍能省不少试错。别人的评价只能当参考,你自己站的层级、主题、多语言设置跟别人都不一样。
上线后怎么验证Google读到了
标记写完不算完,得确认Google读到的版本里有它。三步,按顺序走。
- 用Rich Results Test测。输入要测的URL,不要用代码输入。代码输入有JavaScript限制,例如CORS限制,用URL输入看到的是渲染后的结果。
- 用URL Inspection看Google怎么读这个页面。这一步确认页面没被robots.txt、noindex标签或者登录要求挡住,再看渲染后的HTML里有没有面包屑标记。
- 页面看着没问题,就请Google重新抓取这些URL,再把sitemap提交上去。提交sitemap能让Google知道后面的变化。
发布之后别急着看结果。一个页面发布后,Google找到并抓取它可能要几天。这几天里你能做的是把上面三步走完,剩下的等。
测的类型Rich Results Test不支持,就去Search Console看渲染后的HTML。渲染HTML里有这段结构化数据,Google搜索就能处理它。手上有别的标记类型时,这条用得上。
常见误区和排查:标记对了为什么还不显示
最典型的一种落差:代码测下来没报错,搜索结果里就是没有那条路径。原因官方都写了,按下面几条对。
误区一:标记正确就一定出富结果
不一定。Google的原话是「Google不保证你的结构化数据会出现在搜索结果里,即使页面按Rich Results Test标记正确」。它列了几个原因:结构化数据不能代表页面主要内容或者可能误导;数据有错但测试没抓到;结构化数据指向的内容对用户隐藏。
误区二:为了放标记建空白页
不要为了让标记有个落脚点去建空白页面,也不要标读者看不到的信息,哪怕信息本身是准确的。搜索引擎读的是页面,页面本身没内容,标记再全也说明不了什么。
误区三:面包屑里堆关键词
面包屑的每一项就是一个层级名。一层里塞三四个近义词,读者看不出层级,也分不清点下去会到哪。层级名照站里实际用的分类名写,一句话说完一层。
误区四:把链接一个挨一个串起来
不要把链接一个挨一个串起来,读者难以区分,也失去每个链接周围的文字。面包屑是按层级串的,每一项之间有分隔符,读者知道从哪断开。再往里塞同类推荐链接,就开始混了。
还有一条要知道:结构化数据违规可能导致手动操作,手动操作意味着页面失去富结果资格,但不影响页面在Google网页搜索里的排名。标记写错的代价是少了富结果,改对就行。这套规则在结构化数据标记里写得更全。
排查顺序
- Rich Results Test跑一遍,先清严重错误。
- URL Inspection看渲染后的HTML,确认标记在里面。
- 把必填属性对一遍,缺项的条目没有富结果资格。
- 回头看标记描述的内容,读者在页面上看不看得见。
真实案例:三条插件评价里能核到的问题
插件页面上的用户评价带日期,能核到具体的人和时间。下面三条说的不是一回事。
juanmag,2025年10月4日
用户现在能轻松看到自己在站内的位置,对SEO也友好。这条讲装完之后的效果,没提具体做法,也没提数据。
readysite,2023年4月5日
这个插件在Polylang下对首页不生效。多语言站装面包屑插件,先在最前面那个首页上测一遍。首页不显示比内页不显示更难发现,读者从搜索进来,落地页往往不是首页。
delrod,2023年10月17日
这个插件是完美方案、运行良好。同一个插件,有人说首页不生效,有人说运行良好,差别在站本身。装完自己验证,别人的评价只能当线索。
AI能帮哪几步,人要核什么
面包屑这件事里有几步可以交给AI起草,剩下的动手部分还得自己在后台点。
- 整理层级草稿。把栏目结构发给AI,让它按「首页 > 分类 > 子分类 > 文章」排一遍,你再删改。层级得跟你站的实际结构对得上,AI排出来的只能算草稿。
- 生成JSON-LD草稿。按Google示例的字段,让AI输出BreadcrumbList的代码,包括position、name、item和最后一项不带item。生成完照示例对一遍字段名。
- 翻译报错。Rich Results Test的报错是一串英文,让AI逐条对应到哪个属性缺失或者写错,给出改法。
- 检查锚文本。把面包屑那一串字发给AI,看有没有堆关键词,让它给更自然的写法。
下面三条提示词是本文给的示例,不是官方模板,复制过去改数据就能用。
提示词一:下面是我站的栏目层级:首页 > 分类 > 子分类 > 文章。请按Google BreadcrumbList示例格式,输出这段层级的JSON-LD草稿,最后一项不带item。
提示词二:这是我Rich Results Test的报错文字,请逐条列出它对应BreadcrumbList里哪个属性缺失或写错,并给出改法。
提示词三:请检查这段面包屑锚文本有没有堆砌关键词,按Google链接最佳实践给出更自然的写法。
有三件事得你自己动手:在WordPress后台Settings > Breadcrumb NavXT里逐项填好层级和分隔符;在Rich Results Test里输入要测的URL并点Test URL;在Search Console的URL Inspection里看渲染后的页面有没有面包屑标记,据此决定保留还是改。这三步别人替不了,替你点了,你也不知道自己站上到底输出了什么。
猎者出海的AI Agent在这一步接的活,是把栏目和页面清单整理出来,对照官方字段要求,出一张要改的单子。代码还是你贴,后台还是你点。
常见问题
面包屑导航和结构化数据是一回事吗
不是。面包屑是页面上那条层级导航,结构化数据写在页面代码里。面包屑的标记叫BreadcrumbList,是结构化数据的一种用法。
一个页面能有几条面包屑路径
有多条到达路径时,可以给同一个页面写多条面包屑路径。多数站一条就够,写多了容易跟页面上显示的路径对不上。
面包屑最后一项要不要加链接
不用。最后一项是读者当前所在的页面,加链接等于让页面链回自己。前面几项照常带链接。
面包屑标记加了,搜索结果里为什么没显示
官方不保证标记正确就显示。查三处:标记描述的内容是不是页面的主要内容,有没有测试漏掉的错误,标记里写的东西读者在页面上看不看得见。
用WordPress一定要装插件吗
不一定。主题自带面包屑、能输出带href的链接,就够了。主题不输出的,插件最省事。想把站内优化整体过一遍,可以按站内SEO优化清单一项项对。
面包屑在手机上有富结果吗
官方这份文档只写了桌面端。
面包屑是件小事,装之前花十分钟对一遍层级和环境,比装完再拆省事。站的结构从第一天定好,后面加内容才不会一层一层往上乱挂。猎者出海的AI Agent在建站那十个阶段里会把结构和链接一起过一遍,不用等上线几个月再回头补。

发表评论