

外贸网站SEO最容易搞反的一件事:页面还没被Google收进去,人已经在琢磨排名了。Google在SEO入门指南里写得很直白,没有能让站点自动排第一的秘密。能照做的就三步,先确认页面能不能被抓取和索引,再按官方口径改站内结构和内容,最后用Search Console逐条排查没被索引的原因。这里有个事实得先记住:请求抓取不保证被收录,抓取本身要几天到几周。
对出海做站的人来说,规则是公开的,不用找捷径。但要按顺序做,跳步只会让后面的排查更乱。这篇只讲外贸独立站站内SEO的分步流程和Search Console报错排查,外链只讲合规口径。外贸站多是英文站,中英文站的做法差别写在中文站和英文站区别里。
- 这是什么:Google把SEO定义为帮搜索引擎理解内容、帮用户找到站点。
- 官方怎么说:没有能让站点自动排第一的秘密,也不保证任何特定站点被收录。
- 怎么做:site:查是否已收录,URL Inspection请求抓取,大量URL用sitemap提交。
- 要多久:抓取几天到几周,改动生效几小时到几个月。
- 误区在哪:重复内容不算违反spam policies,别用robots.txt或URL移除工具做canonical。
本文目录
外贸网站SEO到底做什么:Google官方给的定义和边界
SEO是帮搜索引擎理解内容,不是排第一的技术
Google在SEO入门指南里给的原话是「SEO是帮助搜索引擎理解你的内容,帮助用户通过搜索引擎找到并决定是否访问你的站点」。这句里没有排名两个字。它的落点是让搜索引擎看懂、让用户看懂,排名是结果,不是动作。
能收到单,不是因为懂了什么排第一的技术,而是把页面该说的事说清楚了。
Google明说没有自动排第一的秘密,也不保证收录
同一个页面上,Google说没有能让站点自动排第一的秘密,还补了一句,不保证任何特定站点被加入索引,但遵循Search Essentials的站点更可能出现在搜索结果里。
这两句话合起来就是边界:你能做的是提高概率,不是买一个确定结果。外贸站面对的是全球竞争,任何一个词的排名都不是你单方面能决定的,把收录和索引这层基础做好,才有后面的可能。
抓取时看到的页面要和普通用户一致,含CSS和JS
Google抓取页面时,应该看到和普通用户一样的页面,需要能访问用户浏览器能访问的资源,包括CSS和JavaScript。用JS渲染正文和链接的,要确认Google看到的是渲染后的版本。
页面按用户物理位置显示不同信息的,要确认Google从其爬虫位置看到的内容是你满意的,这个位置一般是美国。外贸站给不同国家显示不同价格或语言的,这里要专门看一眼。
动手前先做关键词研究:外贸站选词的三个约束
不用预判每一种说法,Google的语言匹配能理解多种查询
Google在指南里说,不用担心没有预判到用户搜索内容的每一种说法,它的语言匹配系统能理解页面与多种查询的关系。这句解决的是选词时的一个误区:不用把每个近义词都单独做一页。
把一个产品的叫法拆成product、item、goods各做一页,内容差不多,最后互相竞争,这种做法要避免。选词该做的是想清楚一个页面能回答什么问题,不是把一个词拆成十个变体。
内容要有用、可信、先想着读的人
Google对内容的要求翻成大白话就是有用、可信、先想着读的人。这三个词落到外贸站上很具体:产品页要把规格、用途、适用场景写清楚,不能只堆关键词。
可信不是靠形容词堆出来的。供应商页面写清楚工厂能力、认证、交期,比写十句高质量有用。这部分的做法可以看E-E-A-T实操。
关键词调研的工具和步骤不在官方文档里,本篇只给约束
关键词调研的工具和步骤,Google没有写,只给了上面这些内容层面的约束。选词的方法、怎么判断一个词值不值得做,写在SEO关键词研究那篇里。
分析筛词这块,猎者出海的AI Agent能接一步,把一批词里的歧义和噪音先挑出去。
外贸站站内SEO分步流程:从site:查到请求抓取
第一步:用site:查内容在不在索引里
动手第一件事,在Google搜site:你的域名,看有没有结果。有结果说明Google已经找到并在索引里。这一步解决的是页面到底有没有被收录,不是靠猜。
如果没结果,先回查两处:robots.txt有没有挡住抓取,页面有没有加noindex。这两个是合理的不索引原因,先排除掉再谈别的。
第二步:用URL Inspection看Google看到的页面
Search Console里的URL Inspection工具,用来看Google看到的页面是什么样,包括渲染后的HTML。要用这个工具请求索引,得是资源的所有者或完全用户。
页面用JavaScript插入锚文本或正文的,重点看渲染后的HTML里有没有这些东西。没有,说明你给用户看的内容Google没看到,先解决渲染问题,别急着请求索引。
第三步:少量URL请求抓取,大量URL提交sitemap
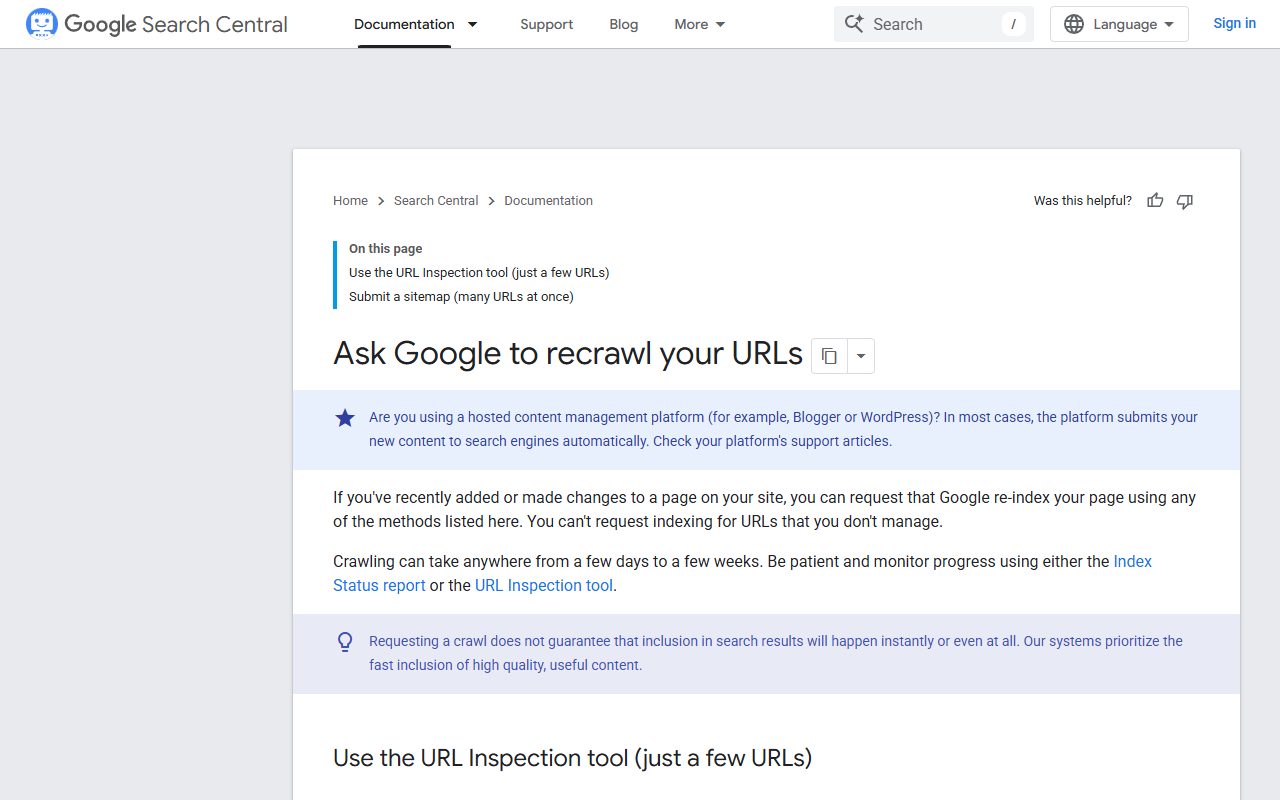
少量URL用URL Inspection请求抓取。大量URL用提交sitemap,sitemap是Google发现站点URL的重要途径,新上线或站点迁移时尤其有用。sitemap还可以包含替代语言版本、视频、图片的额外元数据。具体写法看网站地图sitemap。
这里有两个限制:提交单个URL有配额,对同一URL反复请求抓取不会让它抓得更快。新站上线,最好的第一步是请求索引首页,从首页出发Google才可能爬到其他页面。提交了sitemap没反应,回查sitemap里放的是不是canonical URL,有没有混进noindex页面。
Search Console的注册和报告入口,写在Google Search Console教程里。
第四步:站内链接与锚文本
每个你在意的页面,至少要被站内另一个页面链到,这是Google明确写的。外贸站容易出的问题是产品页只从分类页链一次,分类页又藏得深,最后产品页成了孤岛。
锚文本要描述性、合理简洁,和所在页面及所链页面都相关。不要为了塞关键词堆锚文本,关键词堆砌本身违反spam policies。也不要把链接一个挨一个串起来,读者分不清,每个链接也失去了上下文。
一般只有带href属性的a元素链接才能被Google抓取。用图片做链接、用JS跳转、用按钮而不是a标签,这些都要回查。站点URL超过几千个时,按目录分组对抓取和索引也有影响。
第五步:重复URL用canonical收口
站内出现重复URL是正常的,Google说部分重复内容不算违反spam policies。要处理的是让Google知道哪个是代表版本。指定canonical的方法按影响力从强到弱是:重定向、rel="canonical"标注、sitemap收录。
canonical页自身也要放rel="canonical",叫自引用canonical,建议用绝对路径而不是相对路径。用WordPress这类CMS,可能没法直接改HTML,要在CMS的搜索引擎设置页配置。
不要把noindex用来阻止站内选出canonical页,它会完全阻止该页进入搜索,rel="canonical"才是首选。
第六步:多语言和多地区版本用hreflang
外贸站常有英文、德文、西语多个版本,或者同一语言不同地区版本。Google的规则是每个语言版本必须列出自己以及所有其他语言版本,两个页面不互相指向时标签会被忽略。
alternate URL必须是完整限定URL,包含http或https。hreflang值由语言代码加可选地区代码组成,只支持ISO 639-1和ISO 3166-1 Alpha 2里列出的代码。不能只写国家代码,第一个代码代表语言,Google不会从国家代码自动推导语言。
有语言国家选择器或自动跳转首页的,建议加x-default兜底页。同一语言的不同地区版本,要同时用canonicalization和hreflang。
要等多久、有多少配额:做这件事会用到的数字
这些数字是判断该等还是该查的参照。等的时间不够就去改,改完又等,来回几轮下来,问题没解决,人先烦了。
| 项目 | 数字 | 出处口径 |
|---|---|---|
| 抓取耗时 | 几天到几周 | ask-google-to-recrawl |
| 新页面或新站开始被抓取 | 一周左右 | Page indexing帮助页 |
| 改动生效 | 几小时到几个月,建议等几周再评估 | SEO starter guide |
| 验证修复 | 通常最多约两周,可能更长 | Page indexing帮助页 |
| Page indexing报告示例URL上限 | 1000条 | Page indexing帮助页 |
| 站点少于500页 | 可能不需要用Page indexing报告 | Page indexing帮助页 |
表里最该记住的是两条:请求抓取不是收录保证,提交了也可能不出现;同一URL反复请求不会更快,点一次就等结果。
页面没被收录怎么查:常见误区和排查顺序
先分清合理不索引和该修
页面没被索引不一定是坏事。Google说robots.txt规则、noindex标签、重复URL、已删除页面的404,这些都是合理的不索引原因。先判断属于哪一类,再决定动不动手。
不要期望站点所有URL都被索引,只应该期望canonical页面被索引。目标是让每个重要页面的canonical版本进索引,重复页和替代页不进是正常的。
报告总数远小于页面数,说明Google没找到你的页面
Page indexing报告里总URL数远小于站点页面数,说明Google没找到你的页面,可能因为站点或页面太新,也可能页面无法被发现。回查站内链接和sitemap:Google需要途径才能找到页面,页面必须从已知页面或sitemap被链接到。
只修Source为Website的问题,优先failed和not started
问题列表的Source列标明问题出在Google还是你的网站,一般只能修Source为Website的问题。应优先处理验证状态为failed或not started且来源为Website的问题。
漏一处修复验证就停
修复时如果漏掉一处,Google发现一个残留实例,验证就会停止。所以修复前先把同类页面全找出来,一次改完,不要改一半就点验证。
修复后在问题详情页点Validate fix,验证期间不要重复点。验证通常最多约两周,某些情况可能长得多。
四个官方写明的错误做法
先说最要命的,不要用robots.txt做canonical处理,被禁止的URL仍可能被不带内容地收录。写法看robots.txt写法。
还有个事,不要用URL移除工具做canonical处理,它会把该URL的所有版本从搜索中隐藏。另外两个,不要把URL片段作为canonical,Google一般不支持URL片段;不要给站内所有外链都加nofollow,只在来源不可信时用。canonical的正确写法看Canonical标签。
还有一条跟证书有关:避免坏的TLS/SSL证书和HTTPS到HTTP的跳转,它们会让Google强烈偏好HTTP。证书要匹配完整站点URL或为通配符证书。
站内SEO直接相关的spam红线
cloaking是对用户和搜索引擎展示不同内容,为了操纵排名和误导用户。
隐藏文字是白底白字、把文字藏在图片后、用CSS把文字移出屏幕这类做法,只为搜索引擎放内容,人类访客看不到。
关键词堆砌是在页面里填塞关键词或数字,常表现为不自然的列表或脱离语境。
规模化内容滥用是为操纵排名而不是帮用户,批量生成没有增量价值的页面,包括用生成式AI批量生成。
doorway是为特定相似查询建站或建页,把用户引向不如最终目的地有用的中间页。
这几条触碰了,站点可能排名更低或完全不出现。
外链只讲合规:官方口径下哪些做法不能碰
买卖链接用于排名目的属于link spam,包括用钱换链接或含链接的文章、用商品或服务换链接、送产品换对方写文并带链接。
Google理解买卖链接是网络广告与赞助经济的一部分,只要给a标签加上rel="nofollow"或rel="sponsored"就不违反政策。用自动化程序或服务为站点造链属于link spam,过度交换链接,或者纯粹为交叉链接而设的合作伙伴页面,也属于link spam。
外链建设的具体操作方法,官方文档里没有给,这篇不展开。要记住的只有一条边界:付费链接加标注,程序造链不要碰。
AI能帮哪几步、哪几步必须人来做
AI能帮的是整理、对照、分类这三类活,不能代替你看Search Console里的实际状态。把它当助手,别当判断的人。
能帮的步骤有这几块:
- 把产品页、分类页的现有标题和正文丢给AI,按描述性URL、目录分组、锚文本描述性的官方口径,列出可改的URL与站内锚文本清单。
- 让AI按hreflang规则生成一份多语言页面的对照表草稿,每个版本列出自己和所有其他版本,URL用完整限定地址。
- 让AI把Page indexing报告里导出的未索引原因逐条对照官方原因说明,输出该修和不该修的分类表。
- 让AI按spam policies的条目,检查草稿里有没有关键词堆砌、隐藏文字、批量生成无增量页面这三类风险。
必须人做的有三个动作。在Search Console里打开URL Inspection,输入要查的具体URL,看Google看到的页面和索引状态,据此决定这个页面是请求索引还是先修问题。在Page indexing报告的「Why pages aren't indexed」表里点开具体原因行,看Source列是Google还是Website,只对Website的问题点Validate fix,点一次后等结果。在CMS后台确认canonical是自引用且为绝对路径,改完保存。
下面是本文给的三条提示词示例,不是官方模板,可以直接复制:
「下面是我外贸独立站的20个产品页URL和标题。按Google官方对描述性URL和目录分组的说法,逐条给出是否要改、改成什么,不要编造排名效果。」
「这是我的英文站和德文站页面清单。按hreflang官方规则生成对照表:每个版本列出自己和所有其他版本,URL用完整限定地址,语言代码用ISO 639-1,地区代码用ISO 3166-1 Alpha 2,不要只写国家代码。」
「这是Search Console Page indexing报告导出的未索引原因列表。逐条对照Google官方原因说明,标出哪些是合理不索引、哪些该修,并给出修复动作,不要承诺修复后一定被收录。」
猎者出海的AI Agent在这件事上接两块,一块是SEO/GEO优化,一块是上线运营后每周给一张改稿单。它挡的坑里有一个跟这篇直接相关:站建好了永远不被收录,也不报错。
常见问题
外贸网站一定要用Search Console吗?
不是必要的。Search Console是免费服务,不注册也能被收录。但它能帮你看清Google怎么抓取、哪些页面有问题,外贸站做收录排查基本离不开。
页面被索引了为什么搜不到?
页面被索引不代表一定出现在搜索结果里,搜索结果会按用户的搜索历史、位置等变量定制。索引是资格,不是展示承诺。
新页面多久能被Google收录?
抓取和索引都需要时间,表里的数字可以当参照。加了新内容后Google可能要几天才索引,可以通过请求索引缩短延迟。
页面显示重复未编入索引是坏事吗?
通常不是。被标为重复或替代,说明Google已经找到并索引了canonical页。你只要确认canonical页是你想要的那个版本就行。
用WordPress建的外贸站要手动提交吗?
WordPress这类托管建站平台,多数会自动把新内容提交给搜索引擎,先查平台的支持文档。也可以用Site Kit插件看表现。自动提交不等于一定被收录,该查的时候还是要查。

发表评论