

独立站上做一次A/B测试,最容易搞错的地方不在改页面,在停的时间。多数人跑三天看到B版领先就收工,官方给的规矩是至少跑满一个商业周期,也就是7天。跑多久还轮不到你拍脑袋定,样本量算出来是多少天就是多少天,样本量按基线转化率、MDE、显著性95%这三个参数用计算器算。整套动作是 Optimizely 那套六步框架:收集数据、设定清晰目标、提出假设、设计变体、运行实验、分析结果。
对出海做站的人来说,A/B测试值钱的地方是把「我觉得这样改更好」换成两组访客的真实数据。页面上的每个改动都在花钱买来的流量上跑,没有对照组,你分不清是改动起了作用,还是这周推广多了一点、季节到了。流量还小的站,先把网站运营策划方案里能做的事做起来,再谈测试,样本不够的实验跑起来只是把流量分掉一半。
- A/B测试是什么:把网页或 App 的两个版本随机展示给访客,用统计分析判断哪个版本更达成转化目标。
- 会不会影响SEO:Google 允许并鼓励A/B测试,正常做对搜索排名没有固有风险,拿测试工具做 cloaking 才会出事。
- 怎么做:Optimizely 给了一套六步流程,从找机会到读显著性,每一步都有明确产出。
- 跑多久:至少一个商业周期,样本量用官方计算器按基线转化率、MDE、显著性算出来。
本文只讲独立站上一次A/B测试从头做到尾的流程,工具只当落地载体,不做横评;站还没搭清楚的,先看独立站入门指南把结构理顺,再回来测。
本文目录
独立站A/B测试是什么,和「改版看看效果」差在哪
原版A、修改版B,随机分流再比转化
A/B测试也叫拆分测试或分桶测试,做法是建两个版本:原版叫 control 或者 A,修改版叫 variation 或者 B。访客进来后被随机分到其中一个版本,工具在后台记录两边的互动,最后用统计分析判断这个改动带来的是正面、负面还是中性影响。
判断依据不是哪个版本看着更舒服,是两边转化率的差。差多少才算真的差,要看显著性,那是第六步的事,不能提前下结论。
能测的范围:从标题按钮到整页重设计
可测的改动范围很大,小到一个标题的措辞、一个按钮的文案,大到整页重新设计。网站这边官方列了五类用例:导航设计、页面布局、内容呈现、结账流程、搜索功能。
按业务分还有几种。B2B获客测落地页的标题、表单字段和 CTA(行动按钮);广告活动测广告文案和落地页的搭配;产品内测引导流程和产品内通知。同一个方法,换个位置用而已。
和「直接改版」的区别:随机抽样加统计判断
直接改版是全体访客都看到新版本,你手上只有改版前后两个数。这中间做过推广、换过外链、竞品调过价,都会动数字,改动本身的作用被搅在里面,拎不出来。A/B测试是全量上线之前先分一半流量给新版本,拿这一半和另一半比。
随机分配这一步不能省。随机抽样是拿到准确结果的前提,分配不随机就会引入偏差。所有男性看 A 版、所有女性看 B 版,哪怕比例是 50 比 50,两边的结果也没法公平比较。测试之前该想清楚的是把哪个页面、哪一段流程拿出来测,这属于网站运营策划方案里要先定下来的部分,不是测完再补。
做A/B测试会不会影响SEO,Google 的立场是什么
不会。Google 的态度写得很明确:允许并鼓励做A/B测试,并且声明做A/B测试或多变量测试对网站的搜索排名没有固有风险。
会出事的只有一种:拿测试工具做 cloaking
出事的不是测试本身,是拿测试工具干别的。cloaking 是按访客身份给不同内容,识别到 Googlebot 就给一个版本,识别到普通访客给另一个版本。官方给的禁令很具体:不要滥用访客分群,基于 user-agent 或 IP 地址向 Googlebot 展示不同内容。
这条线画在「给谁看」上,不画在「测什么」上。同一个改动随机分给所有访客,是测试;按爬虫和人的身份分开给,是作弊。分界线清楚,正常做不用怕。
多 URL 测试的两条硬规矩
如果测试跨了多个 URL,比如 A 版在 /p1、B 版在 /p2,就要用 rel="canonical" 把变体指回原版页面。变体页在搜索结果里是重复内容,指回去等于告诉搜索引擎哪一版才是正主。
如果测试是把原 URL 重定向到变体 URL,用 302 临时重定向,不要用 301。测试是临时的,重定向也得是临时的。测试结束把变体撤下来,页面还要回到原地址,用永久重定向就跟这件事对不上。
测完回 Search Console 看自然搜索表现
测试跑完、版本定下来之后,去Google Search Console教程里对照这段时间的自然搜索数据,看曝光、点击、平均排名有没有异常波动。这一步不是去找因果关系,是排除改动上线后抓取和索引出问题的可能。
独立站A/B测试怎么做:六步走完一次完整实验
框架是 Optimizely 给的,六步的顺序不能乱,因为后一步的输入是前一步的产出。每一步下面都写清做什么、为什么这么做、出问题回哪里查。
第一步 收集数据:先找到值得测的地方
用 Google Analytics 这类分析工具找机会,用热力图看用户在高流量区域的行为,把高跳出率的页面挑出来。这一步的产出是一份候选清单,不是一个「我想改」的念头。
理由是测试有成本:一段时间的流量被分成两半、一次设计和开发的工夫、一个可能白跑的风险。值得测的地方有两个共同点,流量够,现状明显不好。
回查:如果数据看了一圈找不到机会,说明这个页面还不该测,换一个页面,别为了测而测。
第二步 定清晰目标:一个指标、一个衡量标准、一个目标提升值
目标要落在具体指标上,比如注册数、加购数、结账完成数,然后给这个指标定衡量标准,再定一个目标提升值。三个都说清楚,后面的样本量才算得出来。
回查:写目标的时候发现自己写了三个以上,砍到一个。同时追好几个指标,最后的结局往往是哪个都没到显著阈值,这条在官方列的失败原因里排得上号。
第三步 提假设:按「问题、解决方案、结果」三段写
好的假设把一个事情拆成三部分:问题是什么、解决方案是什么、预期的结果是什么。假设要基于现有数据,写成清晰的预测;手上几条假设一起排的时候,按潜在影响排序,先测影响最大的那条。
举个例子:问题是结账页第二步流失高,解决方案是把运费说明挪到这一步之前,预期结果是第二步的完成率上升。三句话,一次只针对一个问题。
回查:写不出「结果」那一段,说明这件事还没想清楚,先回去看数据,别急着做变体。
第四步 设计变体:一次只改一个变量
变体要做成具体、可衡量的改动,同时确认追踪代码能正确记录,技术实现自己先走一遍。一次只动一个变量,标题、CTA(行动按钮)、价格展示这三类元素,一次挑一处。改了标题又改了按钮颜色,跑出差异你也分不清是谁起的作用。
官方还有一条提醒:不要从零开始把整个网站重设计一遍,要具体,但要从小处开始。整页重设计塞进一次测试,变量太多,结果读不出来。工具这一层怎么用,可以对照独立站运营工具清单。Optimizely 对 Web Experimentation 的说法是不用部署代码就能跑可视化A/B测试,Wingify(VWO)那边的说法是搭建并测试体验来提升网站转化率。
回查:差异跑出来了但你解释不清原因,先回头看看这一版是不是动了不止一处。
第五步 跑实验:随机分流,中途不看结果
启动之后确认三件事:流量是随机分的、系统在正常收数、没有报错。然后就是等,至少跑满一个商业周期,让一周七天的作息差异都被覆盖进去。
中途不偷看,这条是硬规矩。经典统计方法要拿到有效结果,前提是事先定好最小可检测效应和样本量、不偷看结果、不同时测太多目标或变体。看到第三天 B 版领先就宣布胜利,等于把随机波动当成了结论。
回查:发现两边流量分得不均,先查追踪代码和分群设置,别急着怀疑工具本身。
第六步 读结果:看显著性和置信区间
结果页主要看两个输出,p 值和置信区间。统计显著性的意思是,这个变体和原版之间的转化率差异,不是随机机会造成的可能性有多大。同时把所有指标过一遍,别只看最想看的那个,然后把这次学到的东西记下来,下一次从这条记录开始。
回查:没跑出显著差异,先别急着说「这个改动没用」,按下一节的顺序往回查一遍,问题多半出在测试本身。
样本量、显著性和测试天数:三个数怎么定
这三个数是一条链子。显著性定标准,基线转化率和 MDE 决定每个变体要多少样本,样本量除以日均访客就是天数。顺序反了,先定「跑两周」再往回倒推,数字就成凑出来的了。
| 要定的东西 | 怎么定 |
|---|---|
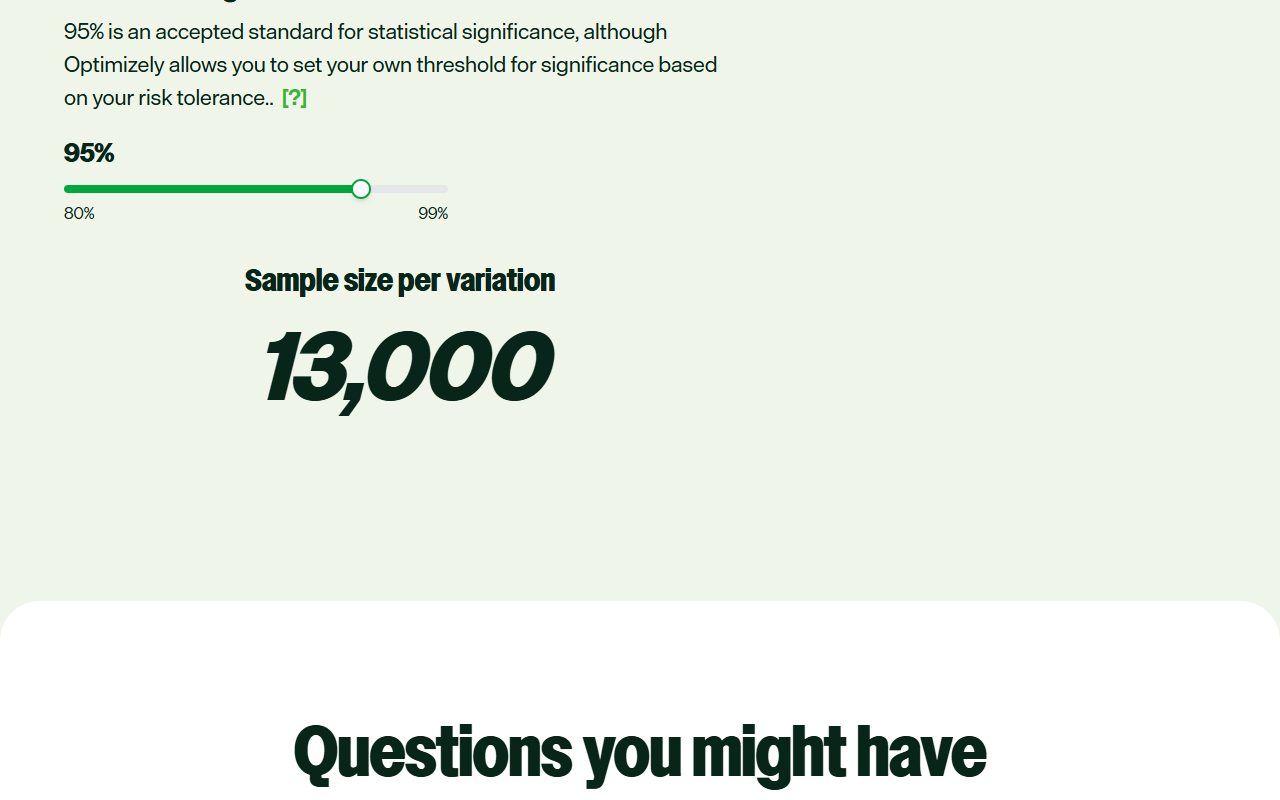
| 显著性标准 | 95% 是统计显著性公认的标准,也可以按自己的风险承受度设别的阈值 |
| 计算器示例参数 | 基线转化率 3%、MDE 20%、显著性 95%,每个变体需要 13,000 个访客 |
| 最短测试期 | 至少一个商业周期 |
| 时长估算 | 所需总访客 = 样本量 × 变体数;预计天数 = 所需总访客 ÷ 日均访客 |
把示例参数代进公式:A 版和 B 版两个变体,13,000 乘 2 等于 26,000 个总访客。这个页面每天来 1,000 人,26,000 除以 1,000,要跑 26 天。日均访客越少,天数越长,长到超过你能等的范围,就该换一个流量更大的页面来测,先测小页面只是在拖时间。
MDE 是什么:能测出来的最小变化
MDE 是测试的敏感度,也就是你希望检测出来的最小相对变化。官方给的例子是这样:基线转化率 20%,MDE 设 10%,这次测试能检测到的,是转化率跑出 18% 到 22% 这个绝对区间之外的变化,10% 的相对效应在这个例子里等于 2% 的绝对变化。
MDE 设得越小,测试越敏感,需要的样本量越大。想抓很细的提升,代价就是几倍的流量和时间。第一次测,把 MDE 设得比「优化一点点」大一些,先跑出一个能读的结果,再谈精细化。
基线转化率取哪一段数据
取这个页面的历史数据,取哪一段影响很大。促销周、投放期、改版前后的数据不能混在一起算,要挑一段没做过大动作的常规时间,取出来的数才有参考价值。填错这一栏,后面每个数都是错的。
测试没跑出显著结果,六个方向往回查
结果页上写着差异没到显著水平,不代表改动没用,也不代表测试白做。官方列过几种到不了显著的原因,按下面的顺序对一遍,能定位到是哪一环出了问题。
改动太小,访客根本感知不到
多数改动对访客体验的影响本来就不大,差异被抽样误差吃掉了。先问自己这个改动有没有大到让人做出不同动作,没有就换一个更实质的改动。
基线转化率太低,指标本身波动大
低基线指标被拿来做代理,结果往往标准差大得读不动。基线太低的页面,先把流量做大,再来测转化率。
目标太多,没聚焦到和假设一致的那个指标
团队没盯住跟假设对应的关键指标,结果就够不到显著阈值。一次只认一个主指标,其他指标当参考看。
受众分群建得太小
给测试建太小的受众分群是官方明确写出来的错误做法,分群太碎容易出假阳性。分群从常用的开始,比如新访客和回访访客,规模要撑得起统计显著性。
分流不随机
分配不随机就带偏差,所有男性看 A、所有女性看 B,50 比 50 也不公平。回后台看分流规则是不是被条件切过。
没等够就下结论
不把统计显著性当回事,会犯第一类错误,以为测试有效应,实际没有。不按科学方法做,还会把纯属随机机会的收益当成显著结果。样本量没跑满之前,结果页上的任何领先都不算数。
还有一种情况出在内容型页面上:变体的文案是 AI 写的,改完转化没动,问题可能在内容本身,不在版式。AI 生成内容这一层怎么影响页面,可以对照AI生成内容的影响,测之前把文案单独核一遍,别把内容问题和布局问题混在一次测试里。
真实案例:四个团队用 A/B 测试跑出来的公开结果
下面四个都是公开案例页上写出来的结果,只记谁、测的方向、结果数字。方法细节那些页面没写,这里也不替它们补。
Ubisoft:测获客,sign-ups 提升 12%
Ubisoft 用 A/B 测试做获客,公开结果是 sign-ups(注册数)提升 12%。具体改了哪几处,案例页没写。
Garanti Payment Systems:测奖励信用卡申请线索,sign-ups 提升 24%
Garanti Payment Systems 用 Wingify 提升奖励信用卡的申请线索,公开结果是 sign-ups 提升 24%。
DeFacto:黑色星期五期间测登录注册,user logins 提升 21.53%
DeFacto 在黑色星期五期间用 Wingify 提升用户登录和注册,公开结果是 user logins 提升 21.53%。时间点写在标题里,测的是大促期间的登录注册动作。
Performics 为 HDFC ERGO:每次转化成本下降 47%,RoAS 提升 1.5 倍
Performics 为 HDFC ERGO General Insurance 用 Wingify 降低每次转化成本,公开结果是 cost per acquisition 下降 47%,RoAS 提升 1.5 倍。这个案例看的是成本,不是注册数。
这四个数字只说明它们自己那一次测试的结果,不代表你照做也能拿到同样的提升。能拿走的是做法,数字留在原地。
用AI帮A/B测试哪几步,哪几步必须自己动手
AI 在这件事里能接的是起草和整理这类活,判断还是你的。拆成两块看:它能替你省时间的四步,和必须你亲手做的三件事。
AI 能帮的四步
- 起草假设。把分析数据里的线索交给它,高跳出率页面、热力图上看到的流失位置,让它按「问题、解决方案、结果」的结构拆成几条假设。
- 把假设转成变体改动清单。标题、CTA(行动按钮)、价格展示这三类元素,每一类具体改什么,列成一张能交给设计执行的单子。
- 估样本量和天数。把基线转化率、MDE、显著性给进去,让它按计算器口径算每个变体和总共要多少访客,并解释 p 值和置信区间怎么读。
- 整理学习记录。一次测试结束,把假设、变体、结果、结论归成一条记录,下次开测先翻这个。这一步可以交给猎者出海的AI Agent,它能把测试结论、页面数据和要改的地方整理成一张单子。
必须你亲手做的三件事
先说最要命的一件,进分析工具后台查出目标页面的历史基线转化率,填进样本量计算器的 Baseline conversion rate 那一栏。这个数错了,后面全错。
接着在计算器里填 Minimum Detectable Effect 和 Statistical Significance,读出 Sample size per variation 那个数字,再决定这次测试值不值得跑。值不值得是判断,不是计算。
还有个事得你自己盯:在测试工具后台把变体建好,确认分流比例和追踪代码都生效,再点启动。测试期间不看中途结果,到期后回后台读显著性,再决定留哪个版本。
三条可以直接抄的提示词
下面三条是本文给的示例,不是官方模板,里面的 X、Y、Z 换成你自己的数。
一:我的落地页基线转化率是 X%,我想检测 Y% 的相对提升,显著性用 95%。请按 Optimizely 样本量计算器的口径,估算每个变体需要多少访客、总共需要多少访客,并说明 MDE 越小样本量越大的原因。
二:这是我的页面数据:跳出率 X%、平均停留 Y 秒、主要流失步骤是 Z。请按「问题、解决方案、结果」结构写 3 条 A/B 测试假设,每条只改一个变量,并标注属于标题、CTA 还是价格展示。
三:我跑了一个 7 天的 A/B 测试,A 版转化率 X%、B 版 Y%,样本量各 Z。请帮我判断结果是否达到统计显著,解释 p 值和置信区间,并列出还需要检查哪些指标。
工具只负责分流和算数,假设和判断还是你的活。把这六步存下来,下次开测之前照着走一遍。
常见问题
A/B测试需要多少访客?
按每个变体的样本量乘变体数算。计算器能把每个变体平均需要的样本量算出来,用它衡量转化率的期望变化,再乘上你要跑的变体数量就是总访客。
基线转化率去哪里查?
查这个页面过去的表现数据,来源是 Google Analytics 或你在用的其他网站分析工具。没有历史数据的页面先跑一段时间,攒出数据再来算。
MDE 是什么意思,设多少合适?
MDE 是测试的敏感度,也就是你希望检测出来的最小相对变化。设得越小样本量越大,第一次测先设一个能跑完的值,别一上来就追很小的变化。
统计显著性 95% 是硬规定吗?
95% 是公认的标准,不是死规定,可以按自己的风险承受度设别的阈值。阈值定得越低,越容易把随机波动当成真差异,这是第一类错误。
测试跑几天可以停?
最短一个商业周期,同时每个变体的样本量要跑满,两个条件都满足才能停。样本量先按计算器算好,中途不反复盯结果,到期再读显著性。
测完这一次,多久能看到效果?
测试给的是这个页面的结论,效果要叠在流量和产品上才看得出来。新站从上线到见到收入大概是什么节奏,可以对照新网站多久能赚钱,别把一次测试当成收入的开关。
跑一次记一次,十条记录之后,你对自家访客的判断会比任何模板都准。猎者出海的AI Agent接的是上线之后的活:自己拉数据,每周给你一张单子,写清楚改哪几篇、改什么、先改哪篇,掉流量的时候帮你排查原因。

发表评论