

标签页不是每个都要留,也不是每个都要删:有独立聚合价值的留着,只是同义词变体的合并或删掉。留下的页面里,重复但想当入口的用rel="canonical"指向首选页,内容薄、不指望被搜到的才用noindex。这两个东西的性子完全不同,canonical是提示不是规则,Google看到以后还可能因为HTTP/HTTPS、重定向、URL是否在sitemap里、rel="canonical"标注这些因素选另外一个页面当canonical;noindex是规则,抓到就把页面从搜索结果里整个去掉。
配错了的后果,不只在收录上。你会看到流量在掉却找不到原因,或者一篇正经文章怎么写都排不过一个空标签页。猎者出海做英文站这块,标签页的问题基本都出在这一步:页面建了,但说不清它替你干什么。
- canonical是提示,Google可能选别的页面当canonical;noindex是规则,被它挡住的页面从搜索结果里整个去掉
- 重复或高度相似的标签页用canonical,canonical页自身也加自引用
- 不要用robots.txt做canonical,不要用noindex在同一站内选canonical
- canonical修复后重新评估有期限,页面重抓也要时间,改完别当天看不到变化就来回改
本文只讲决策和配置,标签是什么、get_the_tags()怎么用这些概念,看网站运营教程那篇。
本文目录
标签页到底建不建:先看它和分类页差在哪
标签页在WordPress里就是一个聚合页,把挂着同一个标签的文章装到一起。
Google对重复内容的处理方式不是惩罚,而是先把看起来一样的页面聚成一组,再从组里挑一个当canonical。站点存在一部分重复内容正常,不违反垃圾内容政策。问题在体验和追踪:同一内容能通过很多不同URL访问,用户点来点去看到的东西一样,你在后台看数据也更难分清哪条链接带来的流量。
Google列出的重复成因里就有站点功能这一类,比如分类页的排序和筛选结果。你把标签和分类叠在一起用,重复面更大。
判断口径就一条:标签页有独立聚合价值才留,只是同义词变体的合并掉。独立聚合价值的意思是,这个标签页装着一批用分类页分不出来的文章,读者点进来能顺着往下看完,而不是看到一堆标题就退出去。
标签是什么、get_the_tags()怎么用,站内那篇tag标签教程有详细写法,这里不重复。
哪些标签页用canonical、哪些才轮到noindex
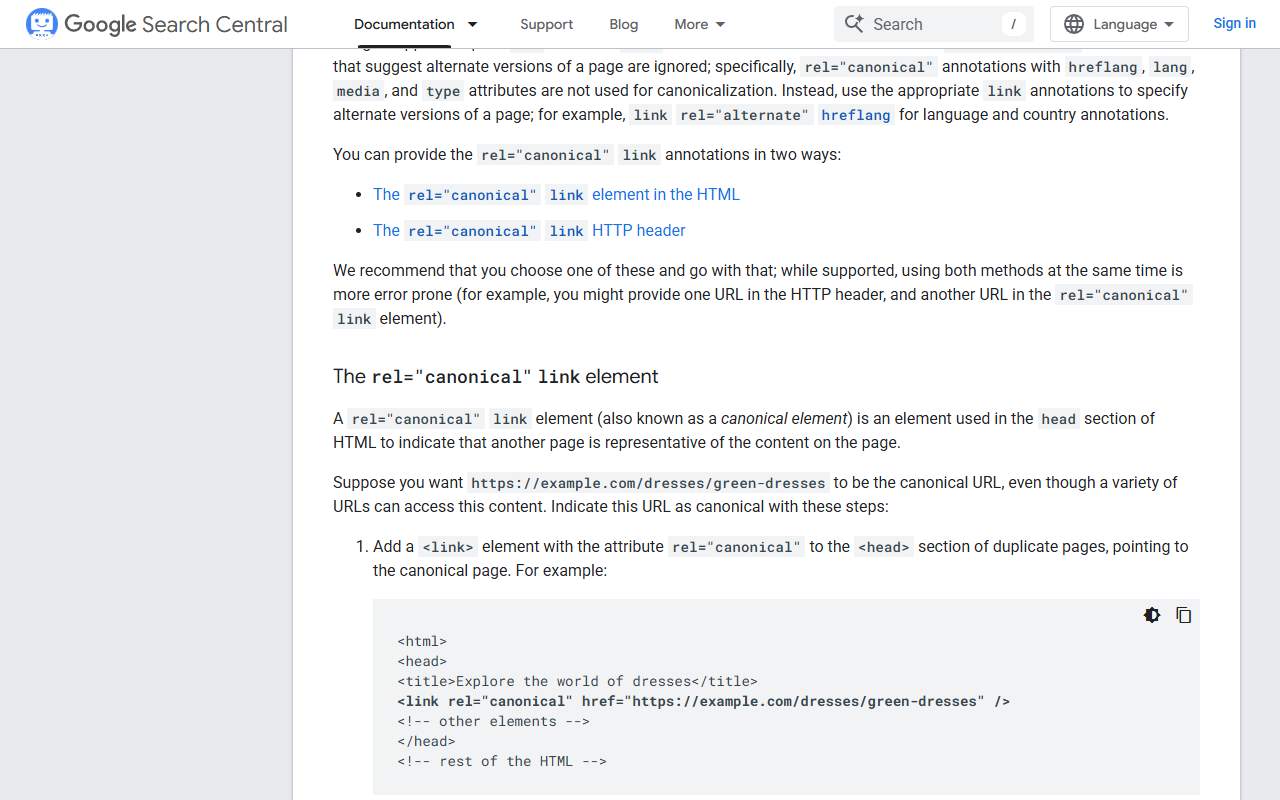
canonical是提示不是规则。你在页面上写了指向某个URL的canonical,Google会看,但最终可能因为HTTP/HTTPS、重定向、URL是否在sitemap里、rel="canonical"标注这些因素,选另外一个页面当canonical。指定canonical的方法按影响力排,从强到弱是重定向、rel="canonical"链接标注、sitemap收录。这三种方法都不是必须的,不指定canonical,站点通常也能正常运作。
noindex的性子跟canonical完全不同。它是规则,Google抓取到就把页面从搜索结果里整个去掉,不管有没有别的站链接它。要生效,页面不能被robots.txt挡住,爬虫得能访问到。Google不推荐用noindex在同一站内阻止某个页面被选为canonical,因为那会把页面从搜索里完全挡住,rel="canonical"才是首选方案。
落到标签页上,取舍线可以这样划:
- 重复但想留作入口:用canonical指过去,页面还在站内可用,信号并到首选页。
- 内容薄、不指望被搜到:用noindex,直接把它从结果里去掉。
- 要彻底去掉已有的重复页:用重定向。最快见效用HTTP(也叫服务端)重定向。
这三条不冲突,但同一个标签页只用一条。想留着在站内当入口用的页面,别用noindex,那是把它从搜索里整个挡住。
照着做:五步把标签页的canonical和noindex配到位
-
第一步,列出重复或高度相似的标签页。把站内所有标签页URL和每页装的文章列成表,标出装着同一批文章的页。Google先把看起来一样的页面聚成一组再选canonical,你不列出来,就不知道哪几页被它放进同一个组里。回查的时候用URL Inspection看Google认为哪个页面是canonical。
-
第二步,在重复页的head段加带rel="canonical"的link元素,指向canonical页。link元素只出现在head段才被接受,head得是有效HTML。路径用绝对路径,相对路径长期看会出问题。回查的时候用浏览器开发者工具看HTML,CMS或插件可能错误地把canonical指向你不想要的URL。独立站SEO优化里有更完整的站内优化流程。
-
第三步,canonical页自身也加自引用rel="canonical"。两种给法,HTML link元素和HTTP响应头,只选一种。同时用两种更容易出错。回查的时候看页面head里实际输出了哪种,别让插件给你加了两种。
-
第四步,确定要完全挡住的标签页,把noindex meta放进head。只挡Google网页爬虫时,用name="googlebot"的noindex meta标签。要挡PDF、视频、图片这类非HTML资源,用X-Robots-Tag响应头。回查的时候用URL Inspection看Googlebot抓到的HTML,Page Indexing报告看Googlebot提取到noindex规则的页面。robots.txt写法里讲了robots规则怎么写,但noindex不要写进robots.txt,Google不支持这种写法。
-
第五步,命名与内链。锚文本描述性强、合理简洁,跟所在页和所链页都相关,不堆关键词。站内链接指向canonical URL,不指向重复URL。别把链接一个挨一个串成排。每个在意的页面至少被站内另一个页面链接到。回查的时候,如果用JavaScript插入锚文本,用URL Inspection确认渲染后的HTML里有这段文字。URL结构那篇讲了目录和命名怎么规划,标签页的URL结构跟它是一套逻辑。
做这件事要用的数字和限制
| 项目 | 数值或条件 | 说明 |
|---|---|---|
| canonical修复后重新评估 | 最长两周 | 修好内容问题后Google可能仍把页面留在重复内容簇里 |
| 页面重新抓取 | 几天到几周;重要度低的页面可能数月 | Googlebot要重抓重处理才能看到更新 |
| noindex生效前提 | 页面不被robots.txt挡住、爬虫可访问 | 被挡住则爬虫看不到noindex,页面仍可能出现在结果里 |
这三行合起来说明一件事:配置改完不等于当天见效,被robots.txt挡住的页面尤其容易让你以为noindex坏了,其实是爬虫根本没看到。
标签页该建几个,别去找通用的数字标准,按文章数和聚合价值逐页判断。找一个数字照着做,多半会做偏。
五个容易出错的地方:标签页还在结果里、canonical指错了
第一个错误,用robots.txt挡页面,以为能不让它进搜索结果。实际URL仍可能出现,只是搜索结果里没有描述。robots.txt主要用来避免站点被请求压垮,它不是把网页挡在Google之外的手段。
第二个错误,加了noindex页面还在结果里。通常是加规则后Google还没抓取过该页面,等重抓就好。另一个原因是robots.txt挡住了URL,爬虫看不到noindex标签,得先去robots.txt里解除阻挡。
第三个错误,用noindex在站内选canonical。Google不推荐这么做,因为noindex会把页面从搜索里完全挡住,rel="canonical"才是站内选首选页的方案。
第四个错误,用URL移除工具做canonical。它会把该URL的所有版本从搜索里隐藏,比你想要的多删一层。
第五个错误,技术层面的几个细节容易把canonical指偏:把URL片段当canonical,Google一般不支持URL片段;同一页面用不同技术指定不同URL作canonical;head里放无效元素,Google会忽略该元素之后的所有元素;robots规则冲突时,更严格的规则生效。
排查按这个顺序走:先用URL Inspection看Google认为哪个页面是canonical,再查技术层面的canonical问题(错误的canonical元素、服务器配置错误、缺失本地化标注),再确保被聚在一起的页面差异足够大。内容差异越清晰,页面通常越快被拆分出来。
还有一个容易忽略的地方:canonical URL在你不拥有的Search Console资源里时,你看不到重复页的任何流量。你以为是流量掉了,其实是数据不在你手上。
canonical的完整概念看Canonical标签那篇。改标签页、合并标签时如果动过URL,旧地址会留下来,用死链接对SEO影响里的方法扫一遍站内死链。
用AI整理标签清单和canonical检查表,哪三步必须人来核
AI能帮的事分四步:
- 把站内所有标签页URL和对应文章数整理成表,标出只有1到2篇文章的标签。
- 按标签名是否与分类名重复、是否只是同义词变体给标签分组,输出合并建议清单。
- 起草标签页的title和description文案,供你挑选。
- 把canonical和noindex的配置项整理成检查清单,逐条对应到后台设置位置。
下面三条提示词是本文给的示例,不是官方模板,可以直接复制:
- 「下面是我WordPress站的全部标签名和每个标签下的文章数,请按文章数从少到多排序,标出文章数为1的标签,并给出合并或删除的建议,不要给排名效果承诺。」
- 「这些标签名里,哪些和我的分类名重复或只是同义词变体?请分组列出,并说明每组保留哪一个作为主标签。」
- 「请为这个标签页写3个title候选和3个description候选,要求描述性强、简洁,不要堆砌关键词,不要写排名承诺。」
必须人动手的有三件。第一件,在WordPress后台「文章 标签」页面逐个看每个标签的文章数,决定哪些保留、哪些合并、哪些删除。第二件,在SEO插件(如Yoast或RankMath)的单篇或分类法设置里,给保留的标签页填canonical指向,或勾选noindex,然后打开前台页面看head里有没有实际输出对应标签。第三件,用Search Console的URL Inspection工具查一个标签页,看Google选的canonical是不是你指定的那个,再决定是否继续调整。
整理资料、对照官方文档、出改稿单这类活,猎者出海的AI Agent能接过去,决定标签页去留和点确认的动作还是得人来。
常见问题
不指定canonical会怎样?
Google会自己判断哪个URL版本最适合展示给用户。不指定也能正常运作,只是你放弃了给Google偏好信号的机会。
noindex和robots.txt有什么区别?
robots.txt主要管理抓取流量,不是把网页挡在Google之外的手段。要挡索引用noindex,或者给页面加密码保护。
noindex对PDF、视频这类文件有用吗?
用X-Robots-Tag响应头处理。meta标签的noindex对非HTML资源不起作用。
canonical页和重复页的抓取频率一样吗?
不一样。canonical页被抓取最频繁,重复页抓取频率更低,为的是减少站点抓取负载。
搜索结果一定指向canonical页吗?
通常指向canonical页。除非某个重复页对搜索用户明显更合适,比如用户在移动设备上时可能指向移动页。
相关文章:WordPress独立站教程。
标签页这件事,判断标准不在建了多少,在每建一个都能说清它替你干什么。说不清的合并掉,说得清的配好canonical或noindex,改完等Google重抓,别当天看不到变化就来回改。猎者出海的AI Agent在上线运营阶段会自己拉数据、每周出一张改稿单,掉流量时排查原因,后续调整跟着这份单子走。

发表评论