

能搭,用n8n或Make都行,先花几天把一条四五个节点的小链跑通,再往里加环节。ai工作流怎么搭建,关键不在工具多强,在你有没有先把五个环节各自的输入字段和输出字段定下来:选品跑出来的表要变成文案的输入,文案要变成商品表的一行,商品表又要变成客服回复时的依据。
n8n把节点定义成工作流的积木,一个节点负责取数、处理数据或者发出数据,几个节点接上,就是一条完整的工作流。中间靠人手复制粘贴,错一次就得回头翻半天记录。先把字段定清楚再挑工具,后面返工少很多。
- 先回答「这个工作流该怎么开始」,定时、表单、消息三选一,再往下串。
- n8n的Starter计划20€/mo,按年付,含2.5K次工作流执行。
- 只有生产执行计入配额,手动跑、子工作流、报错的那次都不算。
- 五个环节里先搭文案和图片,选品和客服放到后面接。
这篇只讲这条链怎么从零搭起来,每个节点取什么数、输出什么字段、出问题回哪里看。
工具怎么选、每个工具能干什么,AI工具这个栏目里按类别列过。如果搭这条链的目的不只是自己用,还想让它变成能收钱的东西,思路可以参考AI自动化赚钱项目。
本文目录
什么是AI工作流,跨境运营为什么要串成一条链
n8n官方文档的第一句是「n8n is a fair-code licensed workflow automation tool that combines AI features with business process automation.」,翻过来就是:它是一个fair-code许可的工作流自动化工具,把AI功能和业务流程自动化放在一起。Make把自己叫做AI自动化平台,可视化搭自动化工作流和AI智能体,运行情况在一个地方看。
两家的叫法不一样,底层是同一个东西。n8n把集成叫节点,节点是工作流的积木:有的节点负责取数,是入口;有的节点负责处理数据,像一个函数;有的节点负责把数据发出去,是出口。一次执行就是工作流的一次运行。Make把积木叫模块,搭出来的整条工作流叫场景。
跨境运营要把五个环节串起来,原因在数据本身。选品跑出来的是一张带价格、销量、评论数的表,文案环节要吃的正是这些字段;文案写完,标题、卖点、描述要变成商品表里的列;商品上了架,客服回复又要知道这个商品是什么、发的是哪家物流。每一环的输出,都是下一环的输入。用手工搬,搬十次错一次,找错的时间比搭链的时间长。
想先看n8n这条路走不走得通,自建和免费额度的细节在自建免费工作流自动化里。
选n8n还是Make:两条路线的差别和适合谁
n8n能开箱连接500+应用,节点式搭建,某个产品的节点没覆盖全部操作时,可以用HTTP Request节点发自定义API调用绕过去;服务连节点都没有,也能用HTTP Request连。Make能开箱连接3,500+应用,任何有API的都能作为自定义集成接进来。
计费口径不一样。n8n按执行次数算,官方说与按步骤或按用户收费的工具不同,它只在工作流从头到尾跑一次时收费;Starter计划20€/mo,按年付,含2.5K次执行。Make按积分算,每个模块执行一次动作消耗积分,多数动作1积分,部分用Make AI Provider的高级功能会更多。
怎么选看两件事。手上要接的应用多、希望拖拽就能看懂每一步在干什么,选Make;要自己部署、希望按执行次数而不是按步骤算钱,选n8n。两边都能先用一句提示词起第一版,n8n这边是n8n Assistant,Make这边是Maia。
还有一条替代路线:已经在用Zapier的,迁移成本要算进去,具体差别在Zapier自动化里。
第一步:先定工作流怎么开始,再一个节点接一个节点
搭之前第一个要回答的问题,n8n官方写得很直白:这个工作流该怎么开始。三种起法最常见:定时,比如每天早上八点跑一次;用户提交表单,比如你填一张选品需求表;消息,比如Telegram发来一条指令。起法定了,后面所有节点的数据形状基本就定了。
官方给的新手示例是四个节点:Schedule Trigger每天早上8点启动,HTTP Request节点去取数据,Edit Fields (Set)节点把取回来的字段拼成一段文本,Data table节点把这段文本插进表格的新一行。四个节点各干一件事,每个节点把结果交给下一个。
搬到跨境这条链上,第一个节点仍然是起法,第二个节点换成取选品数据,第三个节点把字段拼成文案要求的格式,第四个节点写进商品表。先跑通四个节点,再往里加AI和上架。
出问题怎么回查:在画布上点Execute Workflow手动跑一次,逐个节点看输入和输出。手动执行不计入执行配额,可以放心跑。节点里取字段用的{{ $json.city }}这种写法叫表达式,运行时n8n会把它换成真实值,写错字段名就在这里露出来。
如果你习惯先把环境在本地跑通再上生产,本地安装跑通工作流是同一个顺序。
第二步:选品环节怎么接进来
多数卖家的做法是两条:一条是直接用HTTP Request节点调选品数据源的API,另一条是先手动导出一份CSV,再让工作流读表。两条路的目的都一样,把候选品的价格、销量、评论数这些字段拉进工作流,变成后面节点能取的结构化数据。
n8n官方对HTTP Request节点的解释是:它向一个网址(叫端点)发请求,返回那个地址提供的数据,以这种方式共享数据的服务就是API。所以哪怕某个选品工具没有现成节点,只要它对外提供API,就能用这个节点接。
出问题怎么回查:先手动跑一次,看返回的JSON里字段名到底叫什么,再用{{ $json.字段 }}这种表达式去取。字段对不上,就回节点看原始返回,不要凭猜写字段名。有些接口一次只返回一页,翻页参数也要在节点里配。
这一步不点名具体工具,因为各家的接口字段和权限规则不一样,照官方接口文档填就行。
第三步:文案和图片环节,AI怎么接在节点里
这一环要做的事,是把上一步拿到的商品原始数据,变成能直接用的标题、卖点、描述和关键词。用OpenAI的Responses API发模型请求,它支持直接发模型请求、用工具、处理音频图像和文本输入,也支持有状态交互。图片环节同理,把图片地址作为输入传进去,让模型返回图片描述或卖点。
关键在输出格式。自由文本传给下一个节点很难接,用Structured Outputs让模型返回固定字段的JSON,比如title、bullets、description、keywords四个字段,下一个节点直接按字段名取。字段固定了,整条链才有稳定的接口。
出问题怎么回查有两条。一是不能假定模型的文本输出就在output[0].content[0].text,官方写明output数组常有多项,可能还带工具调用和推理token的信息,取文本前先把整个输出打出来看一眼。二是API key从服务端的环境变量或密钥管理服务里取,不写进前端。
文案和图片这两个环节跑顺以后,模板本身也能单卖,工作流模板卖19美金讲的就是这条路。
第四步:上架环节,商品数据怎么自动写进店铺
WooCommerce是WordPress的开源电商平台,核心平台免费,官方称可用REST API和webhooks接入几乎任何服务。WordPress的REST API让应用以JSON对象收发数据的方式和站点交互。所以这一步的动作很直接:工作流最后一个节点,把前面拼好的商品JSON POST到站点。
权限要先想清楚。REST API是面向开发者的功能,公开内容一般可以通过它公开访问,私有内容、受密码保护的内容、内部用户、自定义文章类型和元数据,要鉴权或者专门设置之后才能访问。商品数据属于后者,凭证要单独配,不能拿公开接口去写。
出问题怎么回查:更新后如果商店页或分类页出问题,去WordPress后台的Settings > Permalinks点一下Save,刷新固定链接就能恢复。更新前先备份站点。批量写入的时候先用少量数据试,确认字段映射对了再放量。
这一步只走官方API和官方插件允许的接口,不改平台规则不允许改的东西。
第五步:客服环节,AI回复草稿怎么生成又不失控
动作是把客服对话记录喂给模型,用提示词让它先分类,比如物流、退换、尺码、其他,再输出一个固定结构的JSON:{"type":"","need_human":true/false}。need_human为true的,直接转人工,不进自动回复。
为什么要有need_human这个字段,因为客服这一环要的是可控。Make官方把智能体和AI工作流分得很清楚:智能体是给一个目标,它自己决定步骤;AI工作流是按你定义的路径走,只在特定的判断点用AI。客服回复应该走后面这种,判断点固定,路径固定,出错能定位到是哪一步。
出问题怎么回查:固定模型版本,定期跑评测。模型输出本质上是可变的,快照之间提示词的行为可能变化,保证一致性的办法就是固定版本加评测。同一个分类问题,多跑几次看结果稳不稳。
边界要说清楚:这一环只用平台官方允许的接口读对话记录,回复走官方后台能写的地方。做不到的事宁可不做,别让一条工作流把店铺搭进去。
搭这条链要花多少钱、有哪些额度限制
| 项目 | n8n | Make |
|---|---|---|
| 起步价 | Starter计划20€/mo,按年付 | 免费计划每月1000积分 |
| 计费口径 | 工作流从头到尾跑一次才算一次 | 每个模块执行一次动作消耗积分,多数1积分 |
| 免费试用 | 1,000次执行、5并发、180秒超时 | 免费计划无需信用卡 |
| 积分用完 | 无此机制 | 场景不再运行,入站webhook排队 |
先用免费额度把链跑通,等它每天稳定跑起来,再按执行次数或积分算成本。小链在试用额度里能跑很久,真正花钱是在它变成日常依赖之后。
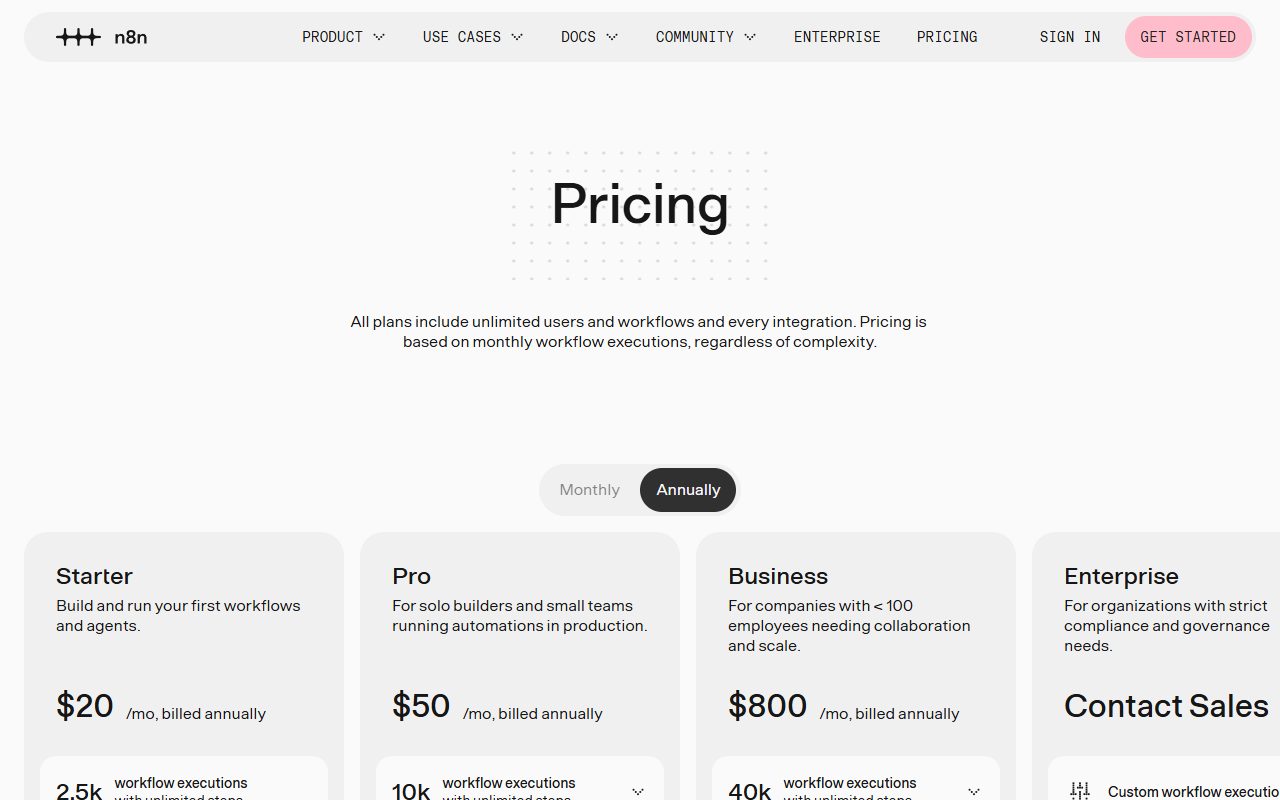
n8n这条还有个折扣:员工少于20人的公司可以申请Startup计划,Business打5折。
几个容易算错的地方,和出问题时的回查顺序
先说最要命的:以为所有执行都占配额。官方写明只有生产执行计入,也就是由触发器、定时或轮询自动启动的那种;手动跑、子工作流执行、报错的那次执行,都不计。
新数据的轮询不计入执行次数。反过来,Schedule Trigger节点每次触发都算一次,不管有没有结果。
Make那边容易栽的是积分。积分一用完,场景就停,入站webhook会排队,等加了积分再处理。另外点Stop也不是马上停,当前模块要把手上所有bundle处理完才会停下来,管不了正在跑的那个模块。
回查顺序:n8n先看工作流级的执行列表,定位是哪一次跑坏了,再把上一次执行的数据复制到当前工作流里调试。Make看执行历史和错误处理器,能看清具体哪一步失败、为什么失败。至于这条链是自己搭还是交给别人搭,AI Agent工作流外包里是另一种选择。
AI能帮你搭哪几步,哪几步必须人来
AI能接的活有四块。一是n8n Assistant,官方说它能把一句提示词变成可运行的工作流,耗时不到五分钟,生成的是第一版,细节仍在画布上改。二是Make的Maia,按提示词搭出场景的第一版,再在画布上细化。三是Structured Outputs,让模型返回固定字段的JSON,环节之间好传。四是web search和file search这类工具,让模型在生成回复时去查网页或者你自己的文件。
人必须亲手做的有三个动作。第一个是在n8n或Make的后台把每个节点的凭证填上,API key从服务端的环境变量或密钥管理服务取,不写进前端。第二个是在n8n画布上点Execute Workflow手动跑一遍,看每个节点的输入输出对不对,再决定发布还是回去改。第三个是在Make里,场景跑完后点模块上方的白色气泡,展开这次操作看它处理了几个bundle,判断积分消耗要不要优化。
文案和图片这两个环节,产出物最像写文章:给一份商品资料,要出一段标题、几条卖点、一段描述。这类活可以先让猎者出海的AI Agent跑一版初稿,你再对着平台要求逐条改。它省的是从零写的时间,判断哪些字段能用、哪些话不能写,还是你自己来。
下面三条提示词是本文给的示例,不是官方模板,可以直接复制去改。
- 「把这条链路拆成节点:定时触发 → 取选品数据 → 生成文案 → 生成图片描述 → 写入商品表 → 客服回复草稿。每个节点写清输入字段和输出字段,输出用JSON。」
- 「下面是一段商品原始数据,请输出JSON,字段固定为title、bullets、description、keywords,不要加别的字段。」
- 「这是客服对话记录,请判断属于哪类问题(物流、退换、尺码、其他),输出JSON:{"type":"","need_human":true/false}。」
常见问题
n8n和Make能不能不花钱先跑起来
能。n8n有免费试用,Make有免费计划,两家都能先跑一条小链。先用免费额度把四五个节点跑通,再决定要不要升级。
不懂代码能搭这条链吗
能搭出第一版。Make官方说任何能理清流程的人都能用提示词、拖拽或AI聊天来搭,不用写代码;n8n也能用n8n Assistant从提示词起第一版。要接没有现成节点的接口时,得看懂接口文档里返回的字段名。
工作流跑起来以后积分掉得太快怎么办
先看bundle数。前面模块的bundle数会对后面模块的操作数产生乘数效应,能合并的数据先合并。官方示例里用Text aggregator把新联系人合并成一封邮件,一次运行的总操作数从11降到3。
五个环节里先搭哪个
先搭文案和图片。这两个环节的输入输出最固定,跑通了就能看到效果,也最容易验证字段对不对。选品和客服留在后面,因为它们依赖外部接口和平台规则,变量多。
客服环节让AI直接回复,会不会答错
会,所以不要让AI直接发。让它先分类并输出need_human字段,为true的转人工,为false的才进自动回复草稿队列。模型版本固定住,定期跑评测看结果稳不稳。
小团队几个人一起搭,怎么分工
一个人管字段和凭证,一个人管节点和回查,第三个人管测试数据。人多了反而容易在同一个画布上改乱。小团队跑自动化的分工方式,小团队跑通自动化里是另一种组织法。
这条链搭完不会一直不变。平台接口会改字段,模型版本会换,执行次数会随着单量涨上去。每周花十分钟看一眼执行列表,比出问题再回头翻记录省事。后面内容那一头的活,猎者出海的AI Agent能接一部分:自己拉数据,每周给一张单子,写清改哪几篇、改什么、先改哪篇。工作流负责把数据搬对地方,判断哪些数据能用,还是人来。

发表评论